El colapso del agente omnisciente en las tuberías de Meta
Cuando los ingenieros de sistemas intentan resolver un problema complejo de ingeniería con modelos de lenguaje, el primer impulso instintivo suele ser crear un superagente dotado de todo el conocimiento posible sobre la infraestructura. Eso fue precisamente lo que hizo Meta cuando buscó automatizar la incorporación de columnas de datos en las tuberías que alimentan sus sistemas de recomendación. La tarea no era tan sencilla, pues implicaba coordinar cambios simultáneos a través de tres repositorios de código distintos, tres lenguajes de programación diferentes y hasta seis etapas consecutivas de procesamiento que debían mantenerse perfectamente sincronizadas.
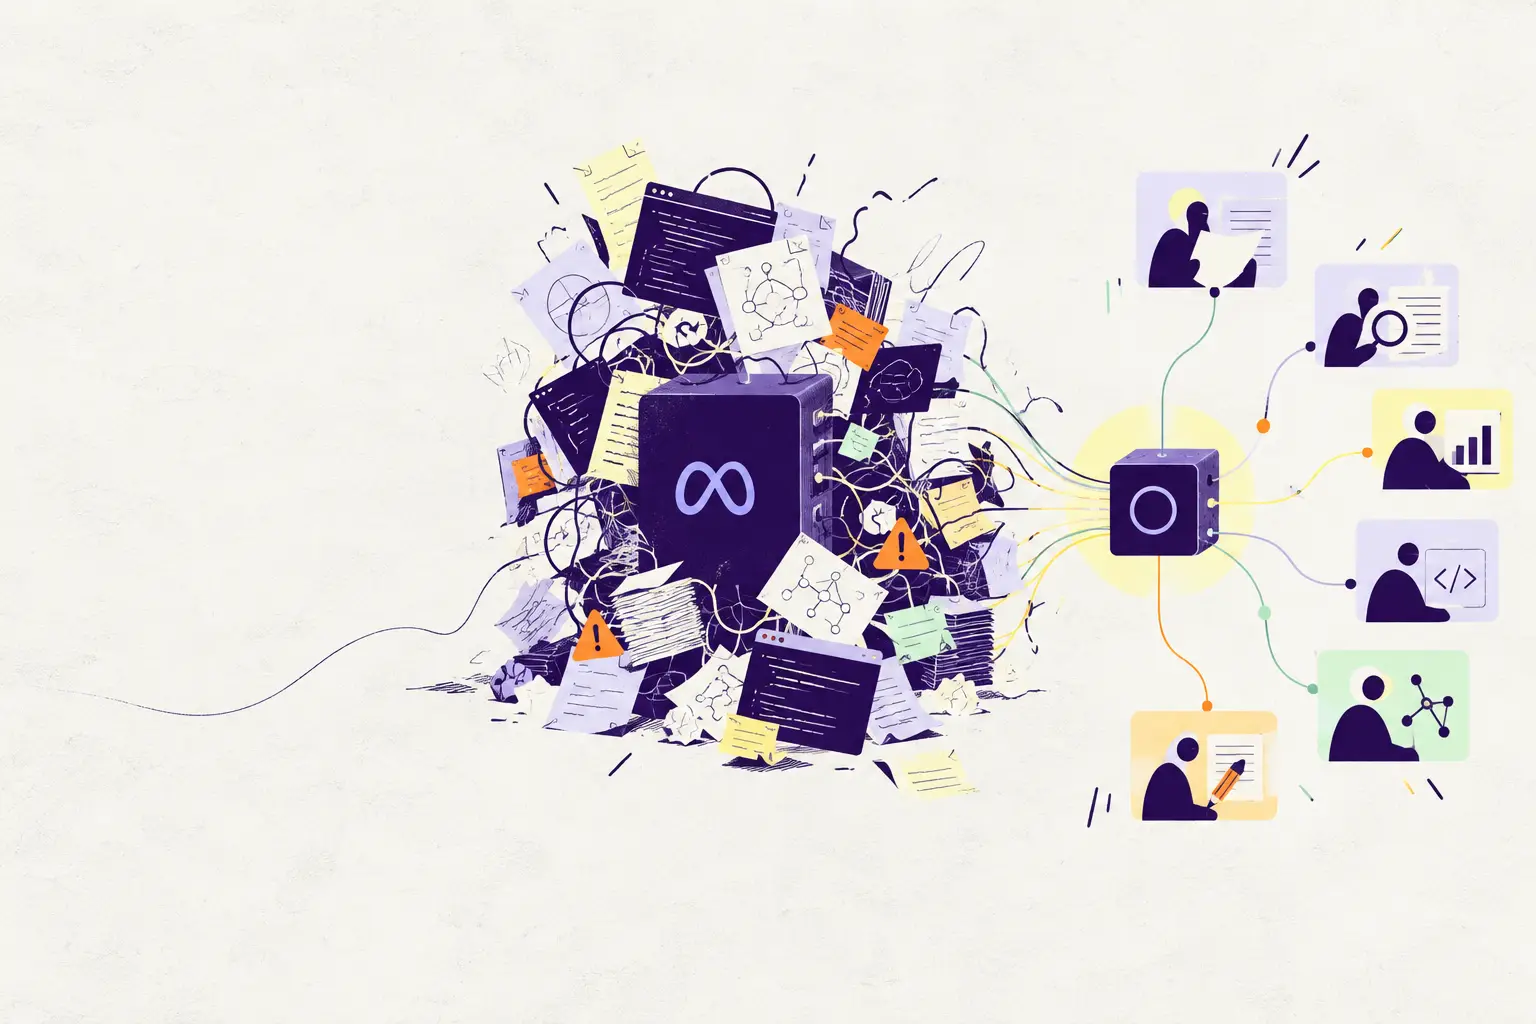
El equipo de ingeniería diseñó inicialmente una única entidad inteligente cargada con esquemas de configuración, reglas de generación de código C++, lógica de enrutamiento de datos, requisitos de validación y patrones de alineación para más de diez fuentes de información. En las demostraciones internas el sistema parecía una maravilla de la automatización. Sin embargo, al desplegarlo en los entornos de producción reales, la máquina empezó a inventar respuestas con una firmeza absoluta.
Según reveló el equipo en el blog oficial de Engineering at Meta el 19 de octubre de 2026, realizado por los ingenieros Plawan Rath, Akhil Jindal y Ashwini Verma, la falla no se debió a la falta de información disponible. El agente tenía absolutamente todo lo necesario para ejecutar su trabajo, y ese fue precisamente el origen del desastre. Al superar cierto umbral de contexto, la acumulación masiva de datos degradó el rendimiento del modelo en lugar de mejorarlo. El sistema comenzó a contaminar conceptos cruzados de subsistemas independientes, aplicando convenciones de nombres de un área a otra o generando código C++ con patrones diseñados para tuberías de analítica completamente distintas.
Esta clase de error resulta dolorosamente familiar para cualquiera que haya observado a un modelo grande de lenguaje producir contenido falso expresado con una autoridad impecable. Como bien analiza la cobertura de PPC Land, la alucinación tradicional ocurre cuando el modelo genera afirmaciones no respaldadas por sus entradas. El caso de Meta presentó una variante mucho más preocupante para los equipos de desarrollo informático, dado que las entradas iniciales eran correctas pero el modelo terminó mezclando las reglas internas debido a la saturación contextual.
Para un equipo especializado en automatización de contenidos o SEO técnico, este fallo expone las costuras de pretender que un solo agente de inteligencia artificial asimile las directrices completas de una web compleja, los parámetros de enlazado interno y las pautas de redacción en una única sesión de trabajo.
Por qué añadir más contexto empeora el rendimiento de los LLM
¿Es posible que saturar la memoria de trabajo de un modelo sea la forma más rápida de arruinar su precisión operativa? La respuesta empírica que ofrece la industria apunta a un rotundo sí. Durante años se promocionó la expansión de la ventana de contexto como la solución definitiva a todos los problemas de recuperación de información, pero la práctica ha demostrado que tener acceso a millones de tokens no equivale a saber razonar eficientemente sobre ellos.
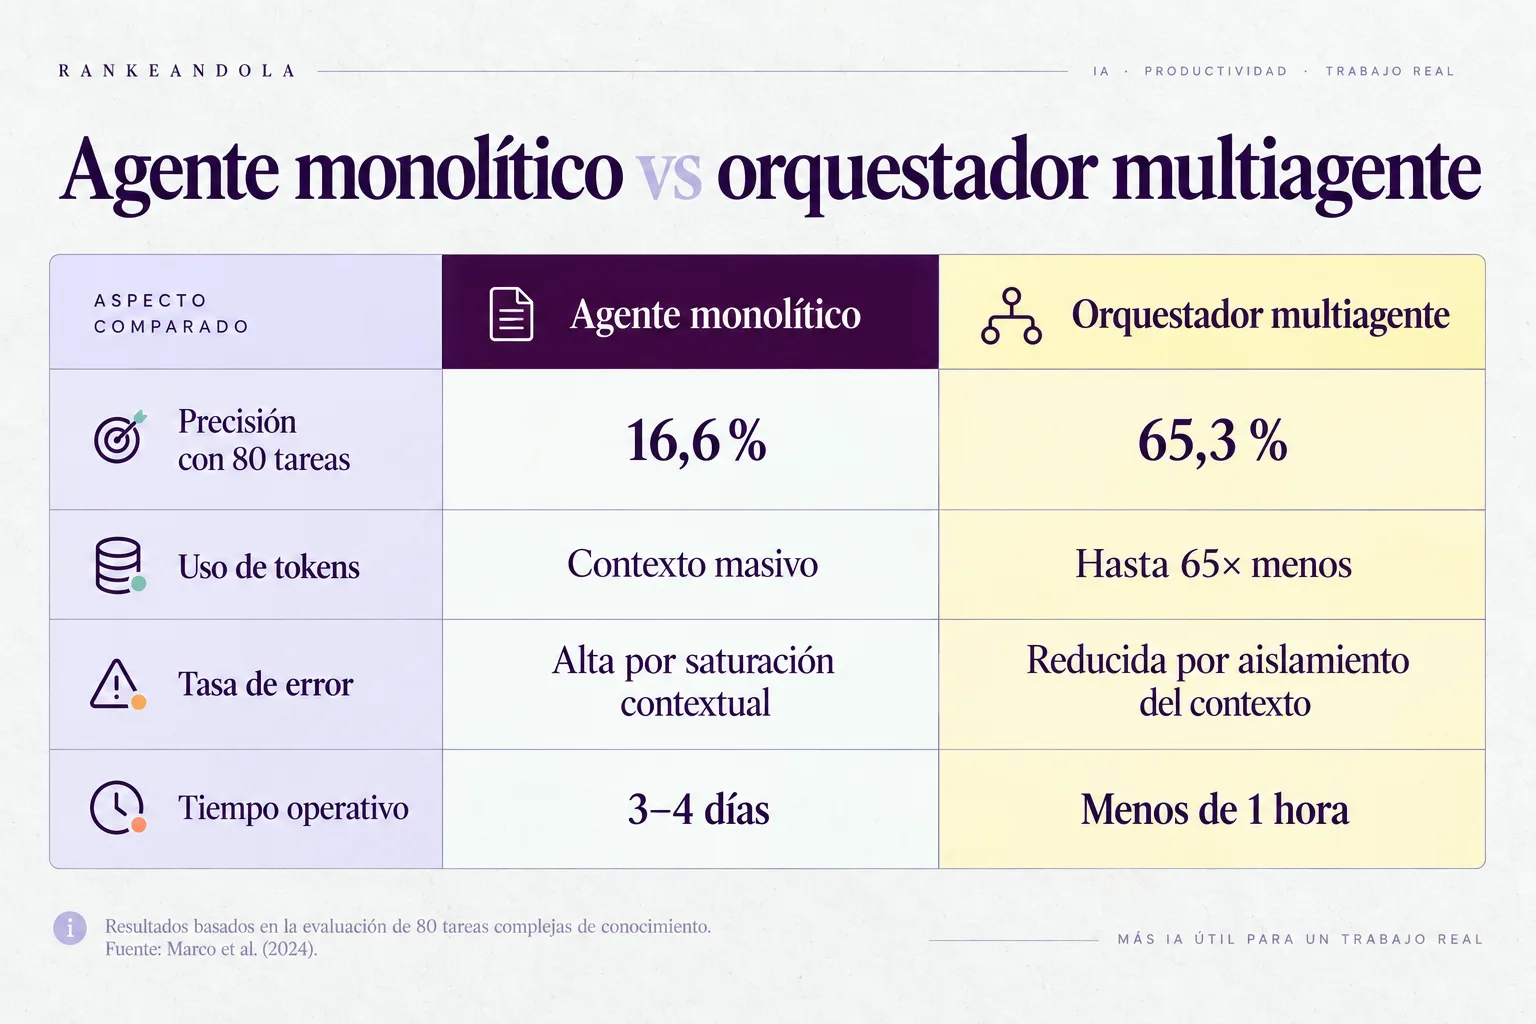
Meta no se limitó a teorizar sobre su experiencia interna, sino que fundamentó su diagnóstico citando un estudio científico independiente desarrollado por el Windreich Department of Artificial Intelligence and Human Health del Hospital Mount Sinai, publicado en npjs Health Systems. La investigación analizó el rendimiento de los modelos de lenguaje sometidos a cargas de trabajo intensivas mediante lotes de tareas complejas. Los resultados revelaron que los sistemas multiagente orquestados mantuvieron una precisión del 65,3% cuando enfrentaban lotes de 80 tareas simultáneas, mientras que los agentes individuales colapsaron de forma drástica hasta registrar un paupérrimo 16,6% de acierto bajo la misma carga operativa.
El estudio del Mount Sinai demostró además que la arquitectura distribuida redujo el consumo de tokens hasta 65 veces, al aislar el contexto de cada subagente y evitar que las instrucciones de una tarea interfirieran con el razonamiento de otra. Meta comprobó de primera mano la validez de este fenómeno al evaluar una segunda alternativa basada en un agente monolítico (Es decir, un solo modelo o agente gigante al que se le carga todo el contexto, todas las instrucciones, todas las reglas de código y todas las fuentes de datos al mismo tiempo para que resuelva cualquier tarea por sí solo). Aquel segundo intento logró entre un 70 y un 80 por ciento de éxito únicamente cuando un ingeniero redactaba manualmente un mensaje del sistema personalizado para cada trabajo específico. En cuanto se retiraba esa supervisión humana paso a paso, la tasa de éxito caía en picado hasta situarse entre el 10 y el 20 por ciento.
Los ingenieros de la compañía concluyeron que no se encontraban ante un problema de ingeniería de mensajes o prompt engineering, sino ante un defecto estructural de arquitectura informática. Cuando un modelo intenta barajar demasiadas variables de dominios heterogéneos, la atención distribuida del transformador sufre interferencias cruzadas. Esto provoca que el sistema elija atajos probabilísticos erróneos que parecen perfectamente coherentes en la superficie. Interesante, ¿no? En pocas palabras: la IA se llena de tanta información a la vez que se abruma y se vuelve 'loca'... Cualquier parecido con la realidad humana es pura coincidencia 😅
Para los estrategas de contenido y consultores que diseñan pipelines para motores de búsqueda conversacionales, esta conclusión marca un punto de inflexión. Intentar resolver la imprecisión de una herramienta alimentándola con documentos cada vez más extensos suele acelerar el colapso del sistema. La lección técnica es tajante, puesto que la precisión no se logra ensanchando la memoria del modelo sino acotando de forma estricta el perímetro de lo que necesita saber para ejecutar una sola acción concreta.
La anatomía del orquestador ligero que ejecuta cero trabajo de dominio
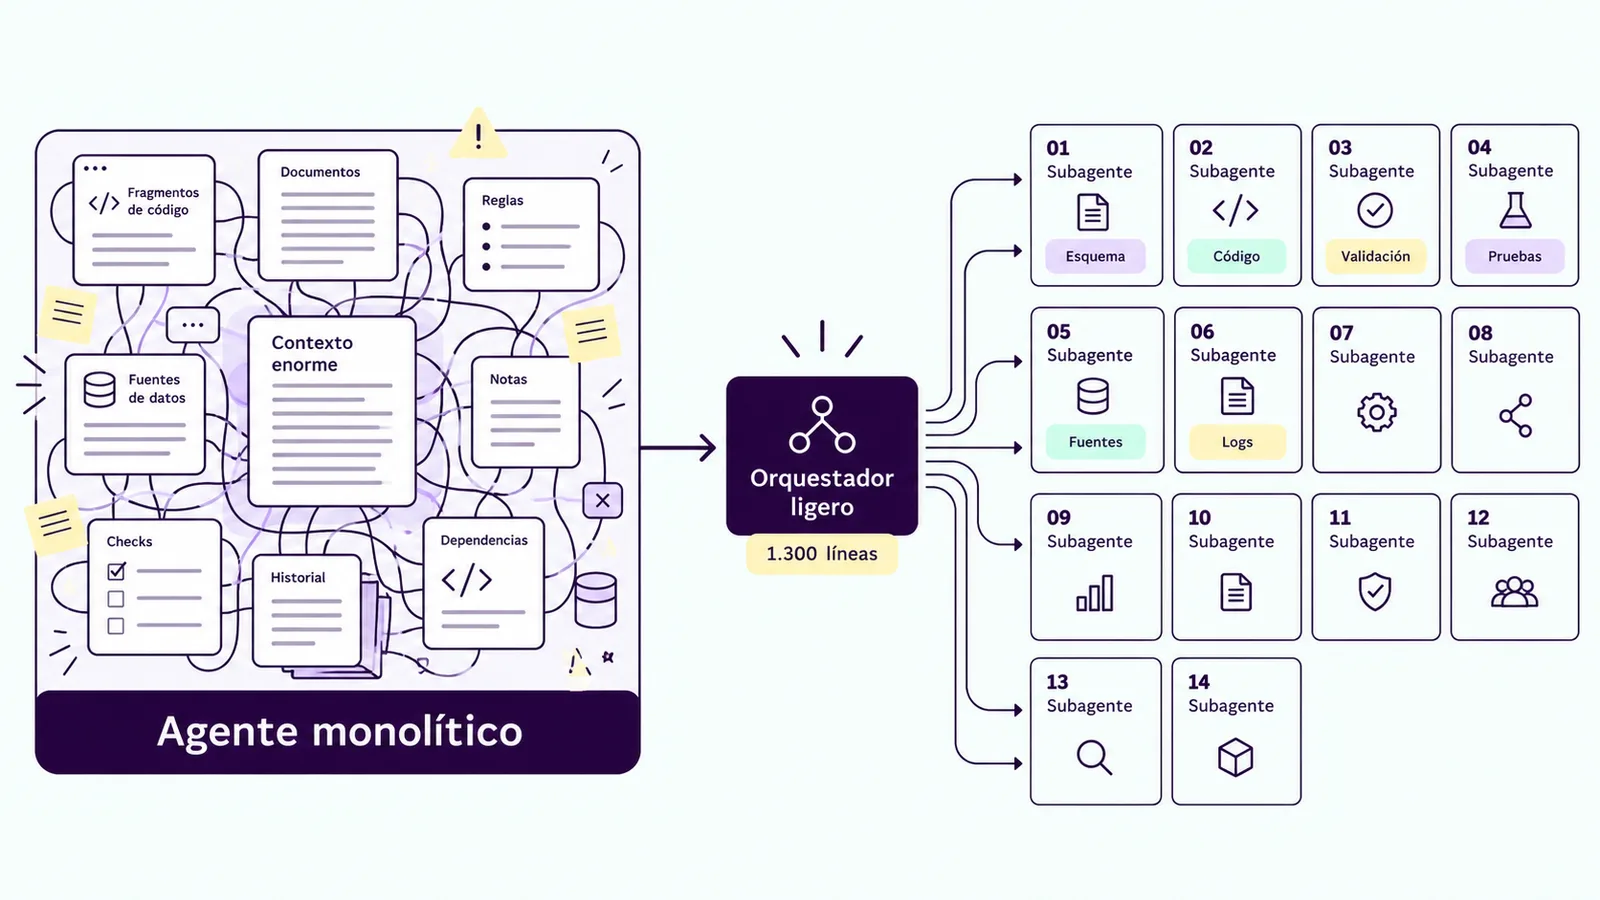
Ante el fracaso del enfoque centralizado, la solución de Meta consistió en rediseñar la arquitectura dividiendo el sistema en dos capas con fronteras infranqueables. La primera capa está constituida por un orquestador determinista compuesto por apenas 1.300 líneas de código, el cual actúa como un simple controlador de tráfico. Este componente no analiza el código fuente, jamás genera archivos de configuración ni interactúa directamente con los repositorios informáticos. Su función se limita estrictamente a clasificar la intención del usuario, recopilar los datos requeridos, verificar los controles de fiabilidad y delegar el trabajo a un especialista.
La segunda capa alberga una red de 14 subagentes especializados, cada uno con un contexto cerrado y aislado del resto de la infraestructura. Existe un agente experto únicamente en el registro de configuraciones, otro especializado en generar código para diez fuentes de datos concretas y un agente de validación que conoce al detalle los sistemas de compilación y pruebas de calidad. La premisa fundamental detrás de esta decisión fue que ningún subagente tenga acceso a la visión general del sistema, convirtiendo la ceguera parcial en una ventaja de diseño.
Cada petición tramitada por la plataforma debe atravesar sin excepción un protocolo fijo de siete pasos secuenciales:
Lectura del archivo de instrucciones específico del subagente asignado.
Comprobación de existencia del elemento destino para evitar duplicaciones innecesarias.
Recopilación de los campos obligatorios proporcionados por el usuario.
Detección automática de variables inferibles en el entorno de trabajo.
Ejecución de un filtro de seguridad para validar advertencias activas o revisiones pendientes.
Delegación formal de la tarea al subagente especialista con su contexto delimitado.
Procesamiento de los resultados devueltos, confirmación del éxito o gestión de errores.
Lo verdaderamente revolucionario de este sistema es que la Inteligencia Artificial solo trabaja en uno de los siete pasos.
Seis de los siete pasos del protocolo se ejecutan con programación tradicional y matemática exacta (revisar duplicados, hacer filtros de seguridad, etc.). El sistema solo recurre a la IA en el Paso 6 (la delegación).
Aquí es donde entran en acción los 14 agentes especialistas: el sistema no le pregunta a una IA "sabelotodo", sino que despierta únicamente al subagente experto en esa tarea específica (por ejemplo, el robot de código o el de validación) para que resuelva el problema en un entorno controlado y sin ver el resto de la empresa.
Esta estructura "acorrala" la incertidumbre de la IA en un solo paso, dejando las reglas de negocio protegidas por software convencional. Es el enfoque opuesto a la tendencia actual de crear un solo agente inflado que intente resolver todo de punta a punta de forma caótica.
Plantillas de trabajo para escalar capacidades sin escribir nuevo código
¿Cómo logra una infraestructura procesar más de veinte flujos de trabajo diferentes utilizando únicamente catorce agentes especializados? La respuesta reside en separar tajantemente el orden en que deben ocurrir las cosas de la ejecución técnica de cada paso individual. Meta resolvió esta ecuación mediante el uso de plantillas de trabajo o workflow templates, que funcionan como máquinas de estados deterministas orientadas a restringir el espacio de decisión del modelo de lenguaje.
La compañía detalló tres plantillas principales en su publicación técnica, orientadas a cubrir necesidades operativas específicas de sus tuberías de datos:
Incorporación de columnas: coordina secuencialmente a los agentes de Esquema, Validación, Población y Pruebas.
Incorporación de eventos: encadena los agentes de Esquema, Población, Validación, Pruebas y Procesamiento de Eventos.
Migración de tuberías: reordena la secuencia utilizando los agentes de Evaluación, Planificación, Población, Validación y Monitoreo.
Cuando los ingenieros de Meta necesitaron implementar el proceso de migración de tuberías, considerado un caso de uso completamente inédito en la empresa, no tuvieron que escribir una sola línea de código para crear nuevos agentes. Simplemente diseñaron una plantilla de trabajo distinta que reorganizó la secuencia de intervención de los catorce agentes ya existentes. Este enfoque demostró que es posible añadir capacidades operativas maduras a una plataforma sin incrementar la complejidad de su código base.
Cada uno de los catorce subagentes mantiene una estructura idéntica basada en cinco pilares clave. Dispone de fuentes de conocimiento delimitadas que cargan únicamente unos pocos miles de tokens en tiempo de ejecución, una lista de verificación previa a la delegación, un plan de trabajo paso a paso, patrones de búsqueda para localizar código en el repositorio central y un mapa de resolución de errores comunes. Esta uniformidad abarata radicalmente los costes de desarrollo, convirtiendo la creación de un eventual decimoquinto subagente, en caso de llegar a necesitar, en una tarea de plantilla totalmente estandarizada.
Las fuentes de conocimiento internas, que superan los 25 archivos organizados por dominio técnico, se cargan bajo demanda en cuanto el subagente inicia su sesión. Si un ingeniero actualiza las instrucciones de un dominio, la siguiente sesión del agente asimila los cambios de forma automática sin necesidad de modificar el orquestador ni reentrenar modelos.
Los resultados operativos reportados por Meta tras adoptar este patrón resultan impresionantes. La preparación de configuraciones para incorporar una nueva columna de datos, un proceso que demandaba entre tres y cuatro días de trabajo manual y cerca de 24 horas con sistemas automatizados previos, pasó a completarse en menos de una hora. Esto representa una reducción de tiempo superior al 98% frente al proceso manual. Asimismo, la compañía asegura que aproximadamente dos tercios de los cambios generados por este sistema se integran en producción sin requerir correcciones humanas significativas.
No obstante, resulta imprescindible ejercer el rigor analítico que exige la lectura de blogs corporativos. Meta no ha facilitado el volumen total de columnas procesadas, la ventana temporal de las pruebas, el número de correcciones rechazadas ni si el tiempo computado por debajo de una hora incluye la revisión final realizada por los ingenieros. Esta cautela analítica cobra mayor peso al recordar que, en publicaciones anteriores como la presentación de su modelo publicitario GEM, la empresa atribuyó incrementos de conversión sin detallar las metodologías de medición empleadas.
El impacto directo en el ecosistema publicitario y la optimización para motores de IA
Aunque la publicación de Meta aborda de forma directa la fontanería interna de sus tuberías de datos, sus implicaciones trascienden la ingeniería de software y golpean de lleno la industria del marketing digital, la tecnología publicitaria y el posicionamiento en motores de búsqueda basados en inteligencia artificial. Los sistemas de recomendación analizados en el informe técnico pertenecen a la misma familia de infraestructura que sostiene la subasta, clasificación y segmentación de anuncios en Facebook e Instagram.
A lo largo del último año, Meta ha acelerado la integración de agentes inteligentes en la gestión de campañas publicitarias. La apertura de sus sistemas a modelos externos como Claude y ChatGPT mediante los Meta Ads AI Connectors, sumada al lanzamiento de herramientas de línea de comandos para la gestión automatizada de presupuestos, otorga a los agentes un control operativo sin precedentes sobre la inversión de los anunciantes. El aviso que lanza Meta con su arquitectura de orquestación ligera es transparente, al confirmar que entregar demasiada información o asignar múltiples atribuciones a un solo agente publicitario provocará decisiones erróneas que pueden dilapidar el presupuesto de un cliente.
Si un agente encargado de gestionar campañas publicitarias asume simultáneamente la redacción de copys, la segmentación de audiencias, la optimización de pujas y la interpretación de métricas de atribución, el riesgo de contaminación cruzada es enorme. El modelo podría terminar aplicando reglas de puja diseñadas para campañas de alcance masivo en estrategias de conversión de alto valor, arruinando el retorno de la inversión.
En el ámbito del Generative Engine Optimization (GEO) y la optimización para buscadores conversacionales como Perplexity, SearchGPT o Gemini, la lección es igualmente crucial. Los motores de búsqueda de nueva generación ya no dependen de un algoritmo único que indexa y clasifica páginas web de forma lineal. Por el contrario, emplean arquitecturas de múltiples subagentes especializados donde un agente evalúa la autoridad de la marca, otro verifica la precisión factual de las citas y un tercero analiza la estructura técnica del contenido.
Si tu sitio web presenta una arquitectura caótica donde las temáticas se solapan sin fronteras claras, los agentes de evaluación de los buscadores experimentarán interferencias al procesar tu entidad corporativa. Facilitar la labor de estos rastreadores especializados exige estructurar el contenido web en silos temáticos perfectamente delimitados, con esquemas de datos explícitos que funcionen como guías deterministas para los agentes de la IA. Si quieres profundizar en el diseño de arquitecturas web preparadas para buscadores conversacionales, te recomendamos leer nuestro artículo sobre La guía más práctica de GEO que vas a encontrar para posicionar tu marca en la IA.
Cómo estructurar sistemas multiagente eficientes en proyectos de posicionamiento web
¿De qué manera pueden los consultores SEO, directores de contenido y agencias de marketing de España y Latinoamérica aplicar el patrón del orquestador ligero en sus operaciones diarias? La respuesta no requiere contratar un equipo de ingenieros de datos ni desarrollar miles de líneas de código, sino cambiar radicalmente la forma en que diseñamos nuestras tuberías de trabajo automatizadas.
El primer paso consiste en erradicar definitivamente los prompts kilométricos que intentan obligar a un modelo de lenguaje a realizar la investigación de palabras clave, el análisis de la intención de búsqueda, la redacción del texto, el formateo HTML y el enlazado interno en una sola llamada a la API. Esta práctica no solo encarece masivamente el consumo de tokens, sino que garantiza la aparición de sesgos, alucinaciones de URLs y textos con una calidad editorial mediocre.
En su lugar, los equipos deben construir un flujo de trabajo basado en la arquitectura de dos capas desarrollada por Meta:
Fase del Proceso | Tipo de Componente | Función Principal | Herramientas Recomendadas
|
|---|---|---|---|
Enrutamiento y Control | Orquestador Determinista | Validar datos, gestionar estados y definir el orden de ejecución sin usar IA | Scripts en Python, Make, n8n, LangGraph |
Investigación de Intención | Subagente Especialista 01 | Analizar SERPs y extraer entidades clave de la palabra objetivo | LLM con prompt acotado y acceso a APIs SEO |
Generación de Estructura | Subagente Especialista 02 | Crear el esquema de encabezados H2 y H3 basado en las entidades | LLM con contexto exclusivo del informe de intención |
Redacción de Secciones | Subagente Especialista 03 | Redactar bloque a bloque siguiendo la estructura prefijada | LLM con instrucciones de estilo y cero acceso al archivo SEO completo |
Validación Editorial y SEO | Subagente Especialista 04 | Verificar el cumplimiento de reglas de marca, enlaces y enlaces rotos | Lógica de código tradicional combinada con validador LLM |
Al aplicar esta separación de funciones, el orquestador principal ejecuta la lógica mediante código tradicional en Python o plataformas de automatización sin código. El script se encarga de verificar si la palabra clave ya fue procesada previamente, consulta las métricas de tráfico en bases de datos locales, selecciona la plantilla de trabajo correspondiente y activa de forma secuencial a cada subagente entregándole únicamente la información indispensable para su tarea.
Si el subagente encargado de verificar los enlaces internos detecta un error, el orquestador determinista captura la falla y reintenta la llamada o escala una alerta a un editor humano, sin permitir que la alucinación corrompa el resto del artículo. Este aislamiento garantiza que la calidad editorial se mantenga estable incluso cuando se generan miles de páginas mediante estrategias de SEO programático.
La industria del posicionamiento web y el marketing digital ha entrado en una fase de madurez donde el entusiasmo ciego por los modelos gigantescos cede el paso a la arquitectura de sistemas rigurosa. Meta ha demostrado que el secreto para lograr que la inteligencia artificial sea realmente confiable en entornos de producción masivos consiste en restar responsabilidad al cerebro central, delegando el trabajo pesado en una red de especialistas disciplinados que hacen una sola cosa, pero la hacen de forma impecable.