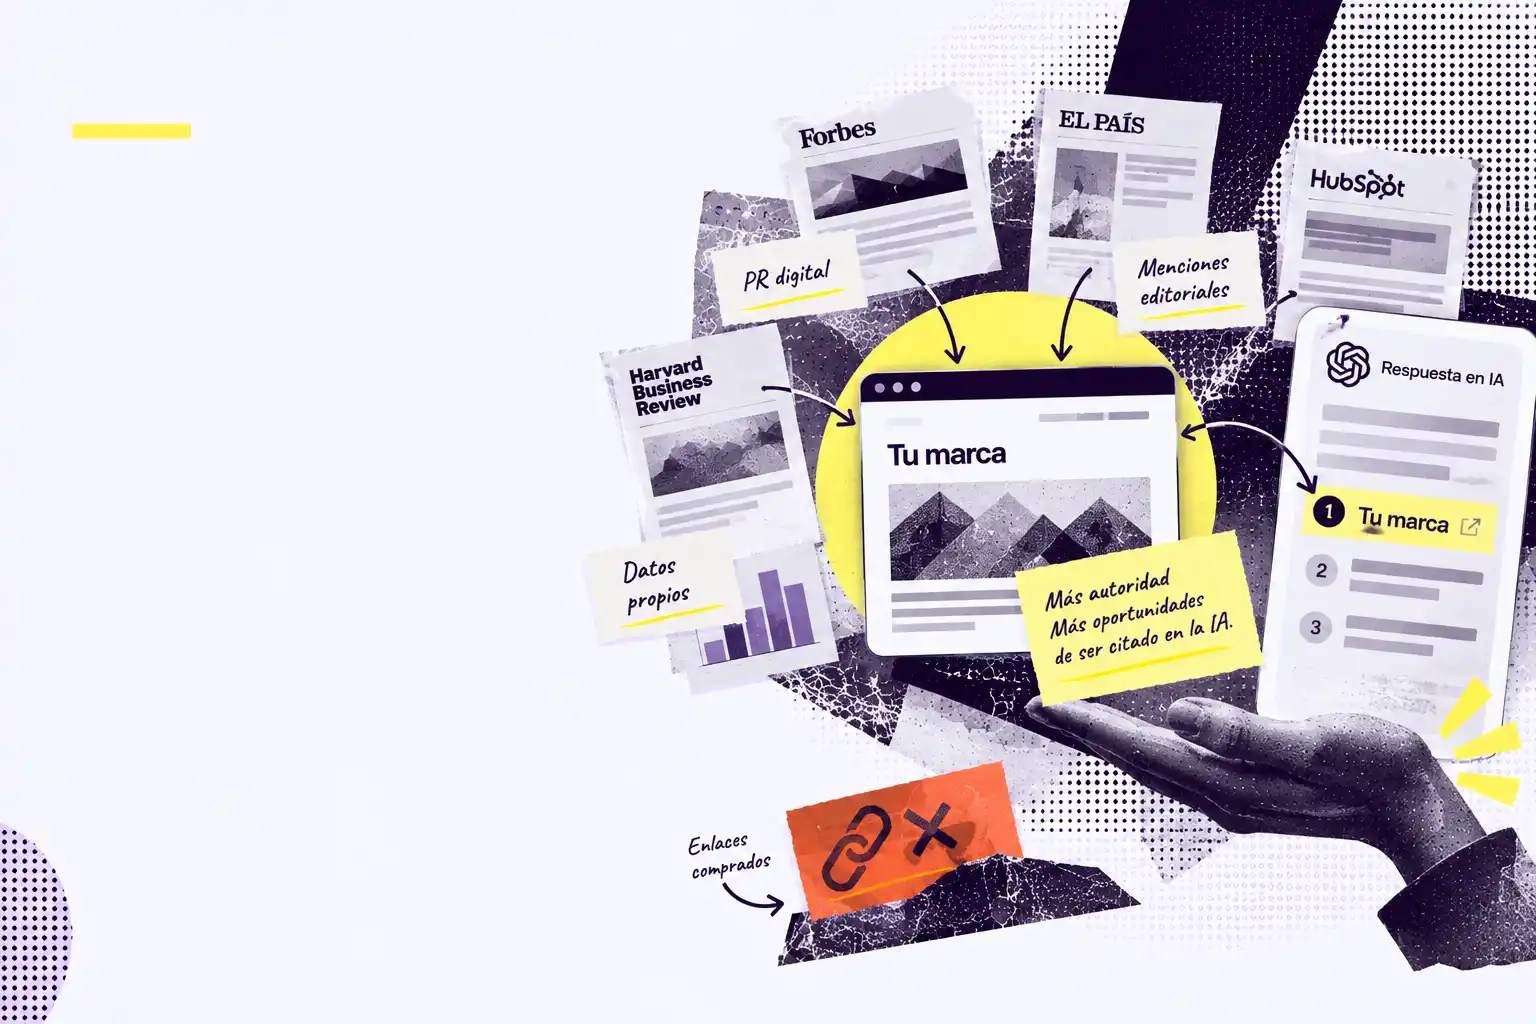
Mientras que el black hat y comercializar con enlaces se centran en la manipulación directa de métricas infladas como el Domain Authority o el Domain Rating de herramientas de terceros, el PR digital ético se enfoca en la generación de interés mediático, la notoriedad de marca y la creación de activos de información imprescindibles.
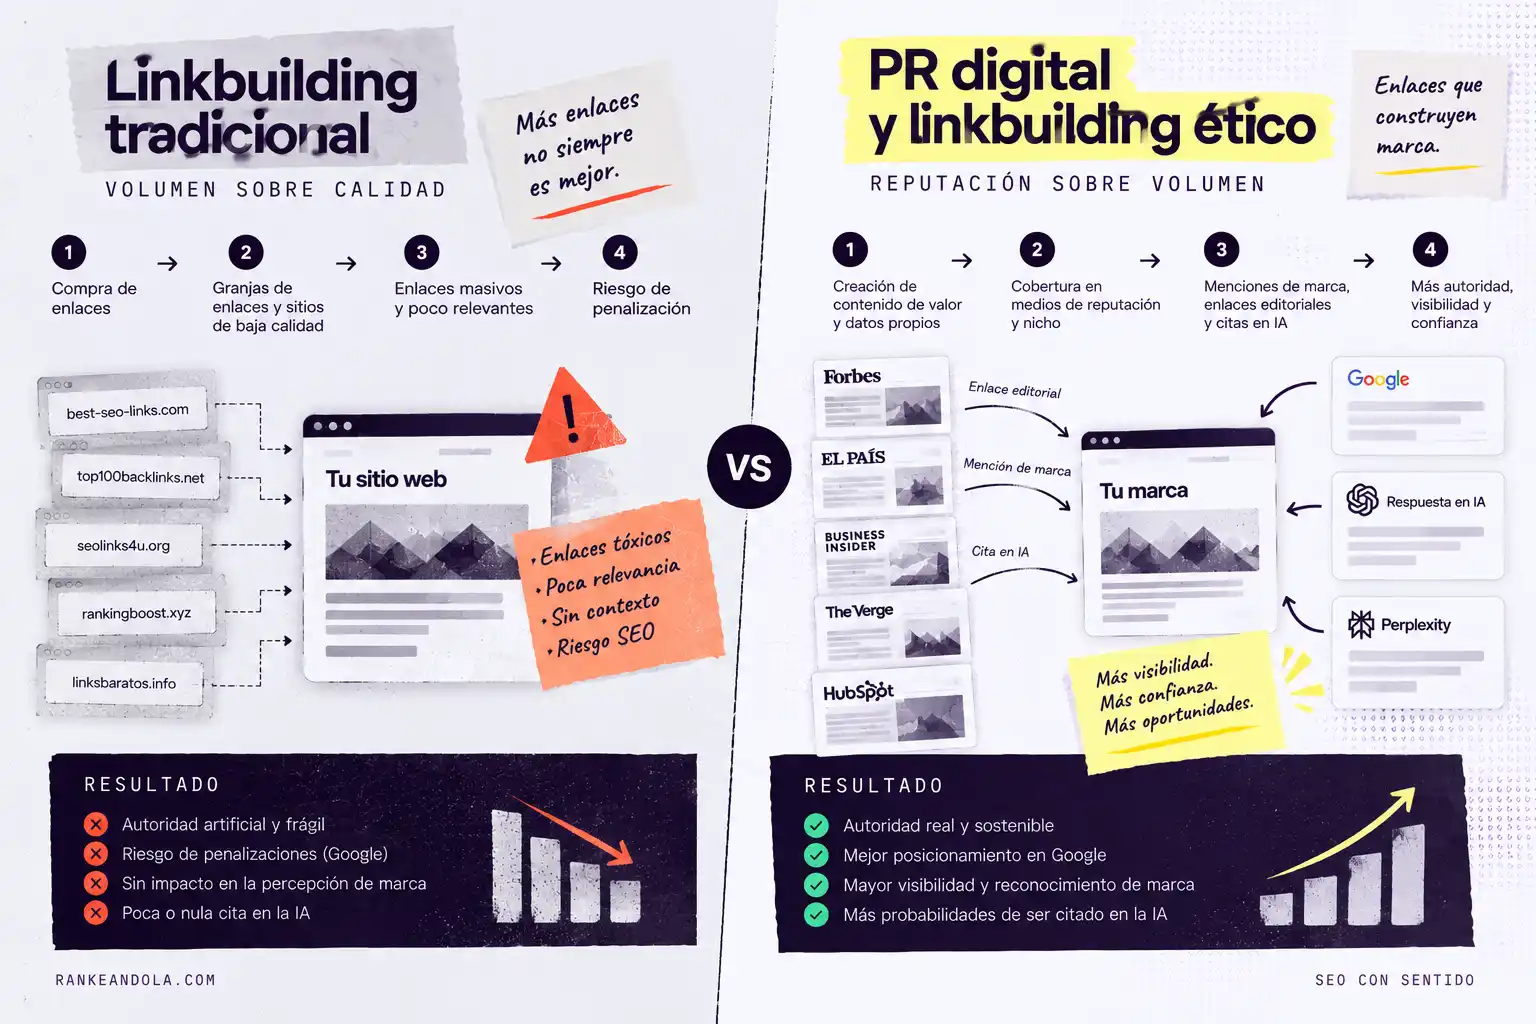
En nuestra lectura del sector, el PR digital y el linkbuilding ético se sostienen sobre cuatro pilares fundamentales que garantizan un impacto duradero.
Relevancia contextual y temática
Un enlace que viene de un blog genérico de noticias que habla el mismo día de criptomonedas, recetas de cocina y consejos de fontanería no aporta ninguna transferencia de autoridad real a tu negocio. Los motores de búsqueda avanzados mapean la web mediante grafos de conocimiento y, si tu empresa vende software de gestión financiera, el enlace más valioso vendrá de publicaciones de finanzas, tecnología, diarios económicos o blogs especializados donde la audiencia realmente consume esa información.
Legitimidad editorial
El periodismo digital y la creación de contenidos de alto nivel tienen filtros, por ejemplo, un medio de comunicación o una revista especializada seria no inserta un enlace porque un gestor haya pagado una tarifa fija a través de un mercado de backlinks, lo hace porque la fuente citada aporta un dato crucial, una declaración experta o un recurso de referencia que complementa la pieza informativa.
Cuando superas ese filtro editorial, consigues una señal de confianza inequívoca que los algoritmos de Google valoran muy por encima de cualquier enlace no supervisado.
Generación de tráfico de referencia real
¿Cuántas personas hacen clic en los enlaces de un artículo patrocinado publicado en la página cuarenta de una categoría oculta de un periódico local? Cero.
Los motores de búsqueda analizan las señales de comportamiento del usuario y un enlace ético y bien posicionado dentro de una pieza informativa relevante genera tráfico de referencia o referral traffic, usuarios reales que navegan hacia tu sitio, interactúan con tu contenido y validan que la recomendación era legítima.
Co-ocurrencia y menciones sin enlace
En el marco del SEO y el GEO, una mención explícita de tu marca en un medio de prestigio, incluso sin hipervínculo cliqueable, es procesada por los motores como una señal positiva de notoriedad.
Google ha desarrollado la capacidad de asociar entidades de marca con atributos específicos de la industria, así que, si tu marca aparece citada de forma constante junto a términos como ciberseguridad, innovación o logística sostenible, el buscador entenderá que eres una autoridad en ese nicho, independientemente de la presencia del atributo href.
Estrategia data-driven y cómo los datos propios son un imán de enlaces y menciones
Si le preguntas a cualquier especialista en SEO qué necesita para publicar una historia relevante, siempre te pedirán datos verificables y frescos. Esto toma más relevancia en este panorama digital saturado de opiniones genéricas y artículos reescritos por IA, porque la información primaria y los datos de elaboración propia se han convertido en la divisa más valiosa de internet.
La estrategia de linkbuilding data-driven consiste en transformar la información interna de tu empresa o investigaciones de mercado diseñadas ad-hoc, en informes interactivos, estudios de tendencias o análisis estadísticos que los medios y otros creadores de contenido deseen citar de forma orgánica.
Los datos propios funcionan estupendamente por:
Nadie te puede imitar. Nadie más en el mercado tiene tus métricas de uso, tus registros de ventas anonimizados, las encuestas exclusivas a tu base de clientes o el análisis de tu propia plataforma.
Citabilidad inmediata. Los que escribimos contenido necesitamos respaldar nuestras afirmaciones con cifras y si el estudio afirma con metodología pública que un porcentaje concreto de las PYMEs en España ha modificado su comportamiento en una variable clave del sector, cualquier otro especialista que escriba sobre eso citará nuestro informe y enlazará a nuestro sitio como fuente original.
Ciclo de vida prolongado. Un buen estudio basado en datos propios no caduca en 24 horas, continúa recibiendo enlaces orgánicos de blogueros, académicos, consultores y estudiantes durante meses o incluso años, cada vez que alguien busca estadísticas para respaldar un artículo o presentación.
Tipo de activo data-driven | Fuente de la información | Potencial de enlaces y menciones |
|---|---|---|
Estudio de tendencias del sector | Encuestas directas a profesionales o consumidores | Muy alto (medios generalistas y revistas de nicho) |
Análisis de datos internos anonimizados | Base de datos propia o uso de la plataforma SaaS | Alto (blogs especializados y prensa económica) |
Herramientas y calculadoras | Algoritmos propios aplicados a una necesidad del usuario | Muy alto (directorios, medios educativos y blogs) |
Barómetros periódicos (trimestrales o anuales) | Muestreos recurrentes sobre una variable del mercado | Excepcional (cita recurrente y referencia fija de la industria) |
En nuestra experiencia asesorando estrategias de contenidos, no hace falta un presupuesto de investigación millonario para ejecutar tácticas de Linkbuilding, pero sí que son indispensables para que tu contenido gane autoridad temática en Internet.
Muchas veces los activos de datos más potentes están durmiendo en las bases de datos de tu propio software o en las interacciones diarias que tus clientes realizan con tus productos. Lo único que requiere tu equipo es la capacidad analítica para estructurar esos datos en una narrativa atractiva o data storytelling.
Impacto directo de los enlaces de calidad en el E-E-A-T
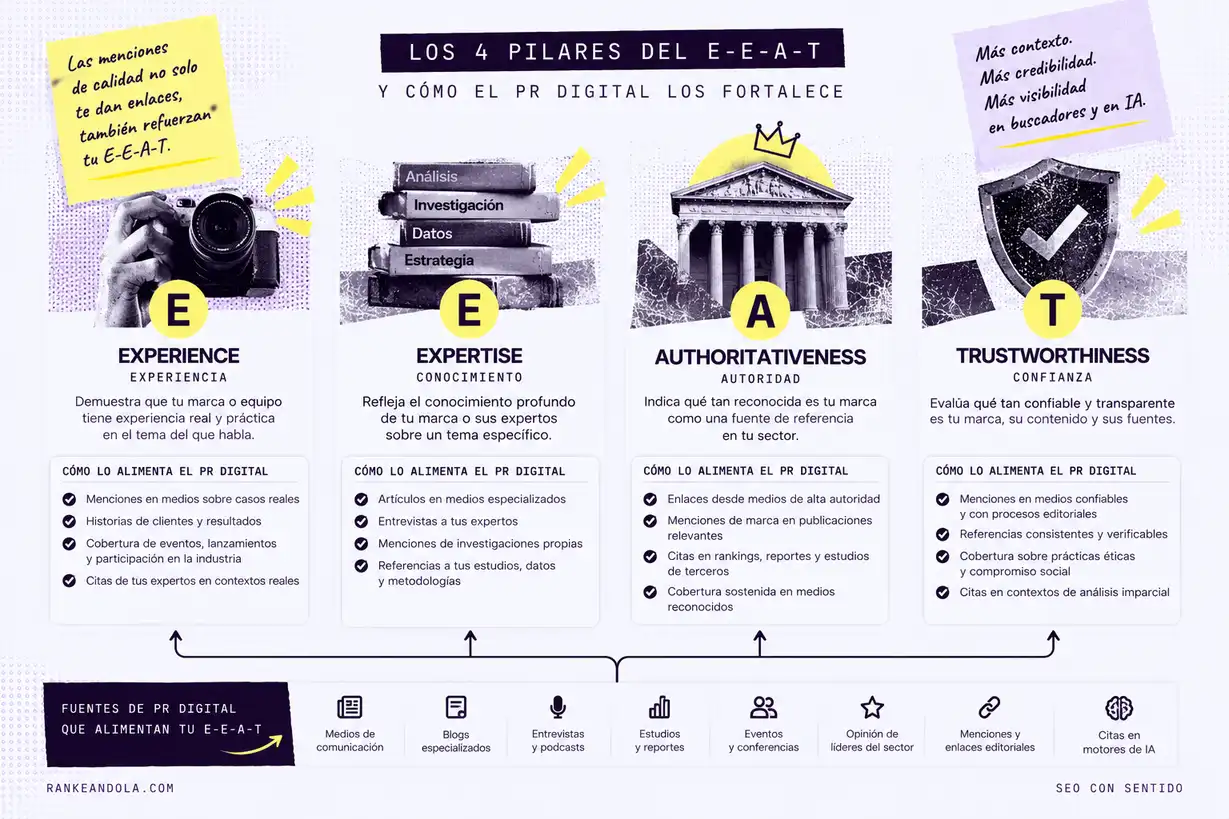
El acrónimo E-E-A-T, con Experiencia, Experticia, Autoridad y Confianza, se ha convertido en el eje central de las Search Quality Rater Guidelines de Google. Aunque no es un factor de ranking directo que se mida con una sola variable numérica, termina siendo el marco estratégico que condiciona cómo los algoritmos clasifican la relevancia de un sitio, especialmente en sectores YMYL como salud, finanzas o derecho.
Así se relaciona el Linkbuilding y el PR digital ético con cada uno de los cuatro componentes:
Experiencia
Cuando los ejecutivos o especialistas de tu empresa participan en paneles de expertos, podcasts del sector o artículos de opinión en medios acreditados, están demostrando el conocimiento práctico acumulado en el día a día.
Google analiza estas apariciones transversales para confirmar que detrás de un dominio existen profesionales reales con trayectoria demostrable, no solo una landing bonita.
Experticia
El enlazado procedente desde publicaciones hiper especializadas ayuda a delimitar el campo semántico exacto en el que destaca tu marca.
Si un laboratorio clínico recibe hipervínculos desde portales de medicina preventiva y revistas de biotecnología, los algoritmos infieren un nivel de experticia técnica muy superior al de un dominio genérico que habla de salud de forma superficial.
Autoridad
La autoridad se construye mediante el reconocimiento de los pares. Cuando los líderes de opinión de tu industria citan tus análisis, enlazan tu investigación o se refieren a tu marca como el estándar del sector, están indicándole a Google que tu entidad es el nodo central de conocimiento sobre esa materia específica. Es la versión digital del prestigio académico.
Confianza
Este es el pilar que cruza transversalmente a los demás, porque si las menciones y enlaces provenientes de sitios con altos niveles de confianza implícita, como prensa nacional, instituciones educativas, organismos oficiales o medios del sector con larga trayectoria, transfieren esa percepción de seguridad hacia tu marca.
Para Google es extraordinariamente improbable que un sitio fraudulento o de bajo valor consiga cobertura informativa positiva en una publicación de reputación consolidada.
Cómo el linkbuilding y las estrategias Off-Page alimentan las citaciones en las IAs
Estamos en el medio del proceso de cambio de paradigma más profundo en la historia de la búsqueda digital, el paso del SEO tradicional hacia el AEO (Answer Engine Optimization) y el GEO (Generative Engine Optimization).
Los usuarios ya no se limitan a introducir palabras clave cortas en una casilla de búsqueda para luego seleccionar la respuesta en una lista de resultados.
Ahora se formulan preguntas complejas, estructuradas y contextuales en motores conversacionales que generan respuestas sintéticas a partir de múltiples fuentes procesadas en tiempo real o almacenadas en sus modelos de lenguaje.
Pero lo que más inquieta es saber cómo deciden ChatGPT, Perplexity, Claude o Gemini a qué marcas citar en sus respuestas y la respuesta está casi en su totalidad en tu huella de autoridad Off-Page.
El funcionamiento de la recuperación aumentada por generación (RAG)
Los motores de IA no se inventan la información de la nada o no deberían hacerlo cuando funcionan correctamente 😂, usan sistemas llamados RAG (Retrieval-Augmented Generation) que quiere decir que cuando un usuario pregunta “cuáles son las mejores plataformas de automatización de marketing para B2B en habla hispana”, el sistema ejecuta una búsqueda rápida en la web para encontrar fuentes de alta reputación que hayan respondido a esa pregunta o analizado ese segmento.
El modelo analiza el consenso de la web en tres pasos.
Identifica qué marcas son mencionadas con mayor frecuencia en artículos comparativos, análisis de medios tecnológicos y reseñas de expertos.
Evalúa la reputación de los dominios donde aparecen esas menciones.
Sintetiza la respuesta citando expresamente como fuente a aquellos sitios que cuentan con una mayor densidad de menciones y enlaces de confianza.
Puede ser que te entregue la fuente de donde extrae la información o no, pero es necesario saber que así la analiza. Aprende más sobre cómo lograr que las IA citen a tu marca en la guía de GEO de Rankeandola.
Menciones no enlazadas y citabilidad en IA
A diferencia del algoritmo de Google de los años 2.000, que requería un hipervínculo HTML estricto para rastrear una ruta de código, los grandes modelos actuales procesan el lenguaje natural, entienden los conceptos, las relaciones gramaticales y la semántica.
Si tu marca es mencionada de forma recurrente en publicaciones del sector como referente, aunque un redactor olvide añadir el enlace http, el LLM aprende esa asociación y cuando un usuario pida a la IA una recomendación, tu marca aparecerá en la respuesta que entrega.
Una estrategia de Linkbuilding y PR digital en este momento de la vida de Internet no busca obsesivamente el enlace dofollow, lo que persigue incansablemente es la citabilidad. Por eso, el objetivo es convertir a tu marca en un concepto inseparable de la solución a un problema concreto en el grafo de conocimiento global.
Cómo seleccionan las fuentes que citan ChatGPT, Perplexity, Gemini y Claude
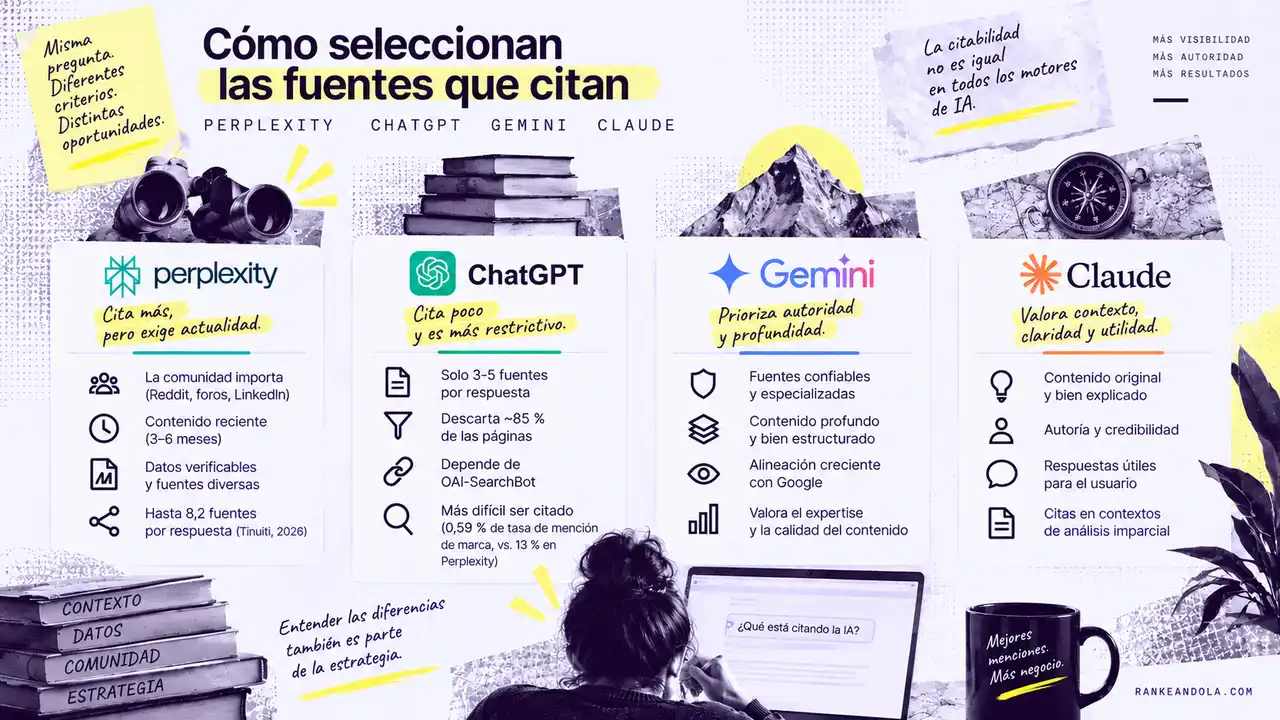
Hablar de citabilidad como si fuera una sola cosa es un error en nuestro parecer, porque cada IA conversacional dominante ahora en 2026 tiene distinta arquitectura de recuperación de información, diferente índice por debajo y un umbral de exigencia determinado. Entonces, optimizar para uno como si fueran todos te puede dejar fuera de los otros.
En Rankeandola llevamos meses cruzando datos de estudios independientes (Tinuiti, Profound, Authoritas, Zyppy, AirOps, Everything-PR Research y las auditorías de citación del arXiv sobre búsqueda por IA) con auditorías propias sobre proyectos hispanohablantes y el patrón es más que evidente.
Los cuatro motores de IA comparten que la citabilidad no enlazada y la autoridad editorial siguen mandando en cómo eligen lo que citan, pero divergen en todo lo demás. Te explicamos.
Perplexity es el motor social que cita más pero exige actualidad extrema
Perplexity es el motor de IA más generoso citando a una marca, con una media de 8,2 fuentes por respuesta según el análisis de Tinuiti de enero de 2026 recogido en el Perplexity Citation Source Index 2026 de Everything-PR Research, unas 3,4 veces más denso que ChatGPT.
Es también el único donde la comunidad importa más que el medio institucional, con Reddit acaparando entre el 20 % y el 24 % de todas sus citas en la mayoría de verticales.
Para Perplexity la arquitectura funciona en tres capas de reranking según la investigación técnica publicada sobre su pipeline por Stackmatix.
La primera capa es una recuperación amplia por BM25 y embeddings semánticos, que trae entre 200 y 500 candidatos.
La segunda es un cross-encoder que evalúa calidad contextual.
La tercera es un reranker de machine learning que aplica señales de entidad, autoridad de dominio, actualidad y diversidad de fuentes y es aquí donde se decide qué llega a la respuesta final.
Las señales que Perplexity prioriza son:
La presencia sostenida en Reddit, LinkedIn y foros verticales, porque el motor trata estas plataformas como fuentes primarias.
La actualidad casi que agresiva, con contenido actualizado en los últimos tres a seis meses ganando peso desproporcionado frente al contenido evergreen.
Las señales estructurales de confianza, con autores nombrados, metodología transparente y corroboración cruzada entre fuentes independientes, no puntuaciones de Domain Authority de herramientas de terceros.
Datos cuantificados y verificables por encima de las opiniones, porque el retrieval prioriza páginas con cifras extraíbles.
Si tu robots.txt bloquea PerplexityBot, vas a quedar fuera de todo el pool de citación y no solo de las respuestas visibles. Y hay que vigilar esto, porque en enero de 2026 Cloudflare documentó comportamientos de rastreo furtivo por parte de Perplexity que llevaron a que fuera retirado de su lista de bots verificados. La conversación sobre esto sigue abierta a ver qué va pasando que seguro aquí en Rankeandola te contaremos.
ChatGPT tiene escasez extrema y dependencia de OAI-SearchBot
ChatGPT es el motor más restrictivo y donde ser citada una marca es más difícil. La tasa de citación de marca en ChatGPT ronda el 0,59 % frente al 13 % de Perplexity, es una brecha de 22 veces.
Solo cita entre 3 y 5 fuentes por respuesta de media y descarta cerca del 85 por ciento de las páginas que recupera antes de generar la respuesta final, según el estudio de AirOps sobre 548.534 páginas y 15.000 prompts recogido por Erlin.
OpenAI opera cuatro crawlers distintos según su documentación oficial, OAI-SearchBot que es el único que decide si tu sitio puede aparecer en ChatGPT Search y hay que permitirlo obligatoriamente en robots.txt, GPTBot que es solo para entrenamiento y se puede bloquear sin afectar a la visibilidad, ChatGPT-User que hace fetches puntuales cuando un usuario pide leer una URL concreta y OAI-AdsBot, añadido en 2026, que valida landings de anuncios.
El error más común es bloquear GPTBot con Disallow global para proteger la propiedad intelectual y arrastrar sin querer OAI-SearchBot con reglas comodín, invisibilizando el sitio en ChatGPT Search sin darse cuenta. Por eso, debes ir a preguntarle a tu webmaster si estás permitiendo que las IA puedan rastrear tu contenido o lo siguen bloqueando. 😀
El índice de ChatGPT ya no es Bing, aunque en el arranque de 2024 sí lo era, pero la alineación con Bing cayó del 26 al 8 % entre 2025 y 2026 según Profound, mientras la alineación con Google subía del 12 % al 33 %.
Ahrefs, por su parte, ha observado que solo el 10 % de las URLs citadas por ChatGPT están en el top 10 de Google. Entonces, vemos que la lectura más defendible es que hoy funciona con un stack híbrido de índice propio de OpenAI más los datos licenciados de terceros, con un reranking agresivo por encima.
Y prioriza 5 señales para la citabilidad:
Permitir OAI-SearchBot sin excepciones en robots.txt, WAF ni Cloudflare.
Renderizado del lado del servidor, porque el análisis técnico de Erlin de 2026 mostró que el HTML estático con schema alcanza un 94 por ciento de éxito en el parsing, mientras el contenido renderizado por JavaScript se queda en el 23 por ciento.
Velocidad extrema, con páginas de First Contentful Paint por debajo de 0,4 segundos consiguiendo una media de 6,7 citas frente a las 2,1 de las páginas que cargan por encima de 1,13 segundos, según los datos de AI Clicks recogidos en el mismo análisis. O sea, unas Core Web Vitals que ni existen. 😂
Estructura extractable, con encabezados semánticos claros, FAQ schema y respuestas directas al inicio de cada sección, porque Authoritas ha documentado que estos elementos aumentan la selección en aproximadamente un 40 por ciento y triplican las citas frente a la prosa plana equivalente.
Presencia en Wikipedia, que acapara alrededor del 12 % de todas las citas de ChatGPT según el estudio de Analyze AI recogido en la misma fuente.
Google Gemini y AI Overviews que son la extensión de tu SEO pero con asteroides
Gemini es el motor de IA más cercano a la lógica de SEO que ya conocemos, pero bien ejecutado. No porque juegue en la misma cancha de Google, sino porque comparte infraestructura con Google Search y por eso los sitios con Knowledge Graph reconocido, marcado Schema.org sólido y ranking orgánico consolidado tienen una ventaja estructural que no existe en los otros tres motores de IA.
No sé si sabías, pero Google no es un motor de IA, se compone de tres superficies distintas con comportamientos distintos; Gemini como interfaz conversacional, AI Overviews como bloque generativo dentro de la SERP tradicional y AI Mode como experiencia inmersiva.
En el análisis de Profound sobre 15.155 setups de marca en mayo de 2026, la media entre la mejor y la peor superficie del mismo Google era de 8 puntos y en más de un tercio de las marcas la brecha superaba los 10. Solo un tercio de las empresas citadas en una IA aparecía en las otras dos.
Gemini es la más selectiva de las tres IA, con 6,6 fuentes citadas por respuesta y unas 4,4 marcas nombradas de media. La arquitectura documentada por ZipTie funciona en cuatro fases.
Recuperación semántica que reduce a entre 200 y 500 candidatos.
Filtrado E-E-A-T que actúa como puerta binaria de aprobado o suspenso.
Reranking a nivel de párrafo por parte del modelo Gemini.
Fusión de datos en un resumen coherente con citas en línea.
Y las señales que prioriza para citar a una marca son:
Completitud semántica al nivel del párrafo, porque el análisis de 15.847 resultados de AI Overviews publicado por Wellows mostró que el contenido que puntúa 8,5 o más sobre 10 en completitud es 4,2 veces más probable de ser citado.
Unidades autocontenidas de entre 134 y 167 palabras que respondan a la consulta sin depender del contexto de la página.
Densidad de entidades reconocibles por el Knowledge Graph, con las páginas con 15 o más entidades por cada 1.000 palabras mostrando una probabilidad de selección 4,8 veces mayor.
Integración multimodal, porque las páginas que combinan texto, imágenes, vídeo y datos estructurados alcanzan tasas de selección un 156 por ciento superiores según la misma fuente.
Presencia como entidad en el Knowledge Graph, que sigue siendo el activo más duradero para cualquier proyecto que quiera aparecer citado en cualquier superficie IA de Google.
Según ZipTie, solo el 38 por ciento de las páginas citadas en AI Overviews están en el top 10 orgánico de Google, frente al 76 % de hace un año, por eso, Rankear alto sigue ayudando pero ya no es garantía y por eso conviene medir citabilidad y ranking como dos KPIs distintos.
Claude es la IA más exigente y la que más peso da a la corroboración cruzada de datos para la citabilidad
Claude es el motor más restrictivo de los cuatro y sus citas son las más difíciles de conseguir precisamente por eso. También son las que más valor tienen cuando llegan, porque su audiencia es notablemente más profesional que la del resto, con presencia en la mayoría de las Fortune 100 y en cientos de miles de empresas B2B. (En esta compañía somos fans de Claude, cómo no).
La arquitectura tiene dos capas de citación que hay que trabajar por separado.
La capa de conocimiento entrenado, donde Claude responde desde su corpus de entrenamiento sin buscar en tiempo real y donde tu marca aparece o no según la huella de entidad que tuviera en la web abierta antes del cutoff del modelo.
La capa de búsqueda en vivo, activada cuando la consulta requiere información actual, que usa Brave Search como retrieval según la documentación de subprocesadores de Anthropic y el reportaje de TechCrunch de marzo de 2025 recogido por SubscribePR.
Que el retrieval sea Brave y no Google ni Bing, tiene una implicación en la citación, porque Brave es de un índice más pequeño y más selectivo que los otros dos buscadores y funciona en la práctica como un filtro natural de calidad.
Entonces, ganar visibilidad en Brave, cosa que casi nadie está optimizando activamente en ninguna parte del mundo, es una de las palancas más infrautilizadas del GEO en 2026.
Anthropic opera tres crawlers según su documentación oficial y todos ellos respetan robots.txt a diferencia de los de OpenAI; ClaudeBot que indexa y evalúa calidad para búsqueda, Claude-SearchBot que alimenta específicamente la búsqueda de Claude y Claude-User que hace fetches puntuales cuando un usuario pide leer una URL. Por eso, bloquear ClaudeBot reduce visibilidad y bloquear los otros dos afecta a otros usos.
Las señales que prioriza Claude para citar a una marca son cuatro y son las más exigentes 👀:
Corroboración cruzada entre fuentes independientes, porque Claude verifica activamente antes de citar y rara vez repite la autodescripción de una marca sin respaldo externo.
Contenido con autoría nombrada, metodología transparente y datos verificables por terceros, con especial preferencia en fuentes gubernamentales, académicas, medios establecidos y organismos sectoriales reconocidos.
Profundidad y estructura, con páginas largas, modulares, con definiciones claras al inicio, encabezados H2, H3, H4, etc. semánticos limpios y evidencia extraíble en formato listable o comparativo.
Actualidad del contenido con fecha visible en la URL o en el marcado estructurado, porque el análisis de citación de Claude publicado por Oltre.ai observó que el 24 % de las URLs citadas en su dataset contenían un año explícito como 2024, 2025 o 2026 en la propia URL y el 47 % eran URLs de estilo listicle o comparativa.
Claude cruza fuentes para evitar información no fiable y prefiere citar la fuente original antes que un resumen de ella. Si construyes tu autoridad reescribiendo lo que dicen otros, Claude cita a otros y no a ti; y si tu contenido es la fuente primaria, te cita.
Señales transversales que priorizar las IA sin excepción
Después de auditar decenas de casos y cruzar los estudios de citación disponibles hasta hoy, hay siete señales que aparecen consistentemente en los cuatro motores de IA que están ultra relacionadas con las políticas de E-E-A-T de Google (quién lo iba a decir 😂); así que, hay que empezar a optimizar por ellas mientras las arquitecturas específicas siguen evolucionando.
Autoría real y nombrada, con fichas de autor completas, credenciales verificables y presencia externa en LinkedIn o perfiles académicos que confirmen que la persona existe y sabe de lo que habla.
Datos propios y metodología transparente, porque la IA busca información que no pueda encontrar en cien sitios más y que pueda verificar.
Cobertura de tu marca como entidad en Wikipedia, Wikidata y bases de conocimiento estructuradas, no como un acto de vanidad sino porque las cuatro arquitecturas de las IA usan estos nodos para desambiguar y validar, esto está respaldado por el análisis cross-assistant publicado en Nature en 2024 que documentó que más del 40 % de las citas de los principales asistentes referencian medios globales del top 100, Wikipedia o grandes plataformas de Q&A.
Menciones consistentes en medios de referencia de tu vertical, con o sin enlace, porque la co-ocurrencia es el pegamento que asocia tu marca con el tema en el grafo de conocimiento.
Estructura extraíble con subtítulos internos semánticos claros, respuestas directas al inicio de cada sección y unidades autocontenidas de entre 130 y 170 palabras que puedan citarse fuera de contexto sin perder sentido.
Actualidad visible, con fechas explícitas de última actualización y actualizaciones sustantivas al menos trimestralmente en los activos estratégicos, algo que el estudio de arXiv de 2024 sobre generative engine optimization cifró en una tasa de citación entre 2 y 3 veces superior en contenido publicado en los últimos 12 meses frente a páginas más antiguas.
Accesibilidad técnica para los bots correctos, con auditoría periódica de robots.txt, WAF y CDN para asegurar que los crawlers de retrieval, no los de entrenamiento, tienen acceso limpio.
Todo esto para saber que la citabilidad en la IA no se compra ni se puede manipular, se gana construyendo, precisamente, lo que defendemos en Rankeandola, una estrategia de Linkbuilding y PR digital ético basado en datos propios, presencia editorial legítima y coherencia como entidad en la web abierta.
La diferencia es que ahora tenemos evidencia técnica granular de qué exige cada motor de IA y podemos priorizar ciertas acciones concretas en lugar de disparar al aire.
Lo que nunca deberías hacer en tu estrategia de linkbuilding o PR Digital
Llegados a este punto nos parece fundamental hablar de las líneas delgadas en las tácticas de una estrategia de Linkbuilding y backlinks, porque para qué seguir ejecutando prácticas Off-Page que desperdicia tu presupuesto de marketing, exponen a tu dominio a penalizaciones algorítmicas directas, te da pérdidas masivas de visibilidad o -nadie lo quiera- te descarte absolutamente por las IA.
Resumimos las cinco prácticas que en Rankeandola nos parecen más nocivas.
Comprar backlinks masivos en plataformas y mercados genéricos
Comprar paquetes de 10, 20 o 50 backlinks en plataformas donde cualquier usuario puede pagar para publicar un artículo en dominios que se dedican exclusivamente a vender enlaces es una señal de alarma para los algoritmos anti-spam.
Google rastrea los patrones de estos dominios, entonces, si un sitio publica diariamente decenas de artículos sobre temas inconexos con enlaces salientes hacia sitios aleatorios, ese dominio pierde todo su valor y los enlaces que emite son anulados automáticamente por sistemas como SpamBrain.
Sobreoptimización de anchor texts de coincidencia exacta
Si el 80 % de tus enlaces entrantes usa como texto de anclaje la palabra clave exacta por la que quieres posicionar, por ejemplo “comprar seguros de coche baratos”, los algoritmos detectarán una manipulación artificial evidente.
El perfil de enlaces de una marca legítima es diverso, natural y heterogéneo donde predominan el nombre de la marca, la URL desnuda, términos genéricos como fuente o sitio web y variaciones contextuales largas.
Redes privadas de blogs (PBNs)
Se trata de construir o alquilar redes de blogs propios creados con dominios caducados para enlazar artificialmente a tu sitio principal es una táctica arcaica.
Las herramientas de inteligencia artificial de los buscadores identifican fácilmente las huellas digitales comunes o footprints como mismos rangos de IP, registros de Whois coincidentes, patrones de diseño idénticos o falta de interacción de usuarios reales.
Este fue muy común hace años, aunque cada vez menos, aunque siguen apareciendo.
Automatización masiva de outreach con plantillas genéricas
Enviar cientos de correos automáticos a periodistas o editores diciendo “hola, he visto tu artículo sobre X y creo que mi enlace quedaría perfecto ahí”, no es PR digital, es SPAM, a las cosas por su nombre. Los medios reciben decenas de estos correos cada día y los filtran directamente a la papelera.
Pero, además del ghosting, esta práctica destruye para siempre la reputación de tu dominio de correo y cierra la puerta a relaciones mediáticas reales que sí podrían haber prosperado con un pitch bien construido.
Ignorar el tráfico de referencia y centrarse solo en métricas sintéticas
Si un enlace proviene de una página con un Domain Authority teórico de 70, pero esa página no recibe ninguna visita orgánica en los últimos seis meses y nadie hace clic en su contenido, ese enlace carece de valor real.
Nuestra recomendación es dejar de juzgar la calidad de las oportunidades Off-Page por métricas creadas por empresas privadas de SEO y empezar a evaluar el tráfico, la actividad y la reputación real del sitio de origen desde donde vienen los enlaces que mencionan a tu marca.
Cómo ejecutar una campaña de linkbuilding basada en activos de información
Para materializar todo lo que venimos conversando, en Rankeandola hemos estructurado un “framework” (llamémoslo) de trabajo en cinco fases consecutivas que puedes implementar dentro de tu equipo o agencia para desarrollar campañas de linkbuilding o PR digital de alto impacto.
Fase 1. investigación y hallazgos de la brecha de información
Antes de escribir nada, hay que identificar qué preguntas de tus clientes potenciales no están siendo respondidas con datos actualizados en tu sector.
Nosotros empezamos por hacer una escucha social y en medios relevantes, analizando las noticias recientes de la industria, qué afirmaciones se hacen sin citar fuentes recientes, qué debates están abiertos.
Seguimos con el análisis de datos internos, examinando la base de datos que ya tenemos para buscar patrones de consumo, cambios de comportamiento o tendencias de uso que reflejen un cambio social o económico.
Y, finalmente, complementamos con encuestas si no encontramos datos internos suficientes, donde diseñamos un formulario básico orientado a una muestra representativa de profesionales o consumidores del nicho que queremos abordar.
Esto, además de ser útil para crear estrategias de backlinks, es súper bueno para crear contenidos para el blog o para las redes sociales de una marca. Si el usuario te dice cuál es su problema, puedes hasta mejorar el mensaje de tu web para que tengas más oportunidades de captar leads.
Fase 2. Creación de un activo de información de alto valor
El activo de información, a menudo llamado linkable asset o data asset, debe alojarse de forma fija en una URL dedicada de tu sitio, no en un PDF descargable sin URL rastreable ni indexable y trabaja tres frentes en paralelo:
Redacción clara y concisa, presentando las conclusiones principales en los primeros párrafos con metodología de pirámide invertida.
Formatos visuales reutilizables, incluyendo gráficos claros, infografías descargables y mapas de datos con tu logotipo de marca incorporado, porque los periodistas suelen descargar e insertar estas imágenes en sus artículos generando menciones y enlaces directos hacia tu fuente.
Metodología transparente, explicando detalladamente cómo se obtuvieron los datos, el tamaño de la muestra y las fechas de recopilación, porque la transparencia es la clave del E-E-A-T en todo Internet (aunque no te lo reconozca sino Google).
Fase 3. Prospección hipersegmentada y desarrollo de ángulos periodísticos
Olvídate de listas de correo masivas con miles de contactos, cero contra cero. El PR digital requiere precisión tipo Hannibal Lecter, entonces, empieza identificando a esos periodistas de nicho que ya sé que tienes identificados, busca redactores en blogs de tu sector, colaboradores freelance y creadores de contenido que hayan cubierto temas similares en los últimos tres meses en medios nacionales, regionales o especializados.
Crea notas de prensa con enfoque periodístico y adapta el mensaje según la especialidad del periodista o del medio. Por ejemplo, a un medio económico le interesará el impacto financiero del dato, a un medio tecnológico le interesará la innovación del proceso, a un portal regional le interesará la estadística local.
El pitch de correo perfecto tiene dos componentes -en nuestra experiencia-, pero siempre es que es bueno que experimentes con lo que tú quieras.
Un asunto directo que incluya el dato más impactante o la conclusión principal, del tipo “Estudio, un porcentaje concreto de las startups en [país] ha modificado su proceso de facturación por la adopción de IA”, siempre con un dato verificable que puedas defender ante quien pregunte.
Un cuerpo breve de menos de 200-300 palabras que salude de forma personalizada, donde te presentes y digas quién eres y por qué conoces a esa persona (siempre cuidando la protección de datos), present los tres puntos clave del estudio en formato conciso y facilite el enlace al estudio completo y a la carpeta de recursos de prensa con imágenes de alta resolución, gráficos y fichas del portavoz.
Dile que si le interesa publicar sobre este tema, con todo el gusto puedes pasarle más información. Ah, y síguelo en LinkedIn antes de enviar este email, que siempre la persona que reciba un correo tuyo, al menos, reconozca tu cara de alguna parte.
Fase 4. distribución, respuesta rápida y gestión de menciones
Cuando un escritor de contenidos muestra interés o publica tu noticia, la labor no ha terminado, puede pasar que te pidan disponibilidad para entrevistas para ampliar la información, aportar comentarios expertos o participar en grabaciones.
Monitorear en tiempo real usando herramientas de alerta de marca para rastrear cuándo se publica tu información es importante, así como seguir la conversión de menciones no enlazadas, que es probablemente la palanca de mayor ROI de todo el framework.
Si un medio publica tus datos y cita el nombre de tu empresa pero no incluye un hipervínculo, envía un breve mensaje de agradecimiento al redactor y solicita amablemente si es posible incluir el enlace directo hacia la metodología del estudio para facilitar la fuente a sus lectores. Pide que, de ser posible, sea <dofollow>.
La tasa de éxito de esta petición es enormemente alta si se aborda con educación y valor periodístico que convierte una mención pasiva en un backlink editorial legítimo.
Fase 5. Medir el impacto multidimensional
Mide el éxito de tu campaña usando métricas globales que integren SEO, reputación y visibilidad en IA para los enlaces conseguidos, evaluando la calidad, la relevancia temática y el tráfico de los dominios que han enlazado tu activo.
Verifica el tráfico de referencia y las interacciones, analizando en Google Analytics la cantidad de usuarios que llegaron desde esos enlaces y su comportamiento dentro de la web y monitorea la presencia en IA realizando pruebas de consulta en ChatGPT, Perplexity, Claude, Gemini sobre el tema investigado para verificar si tu marca o estudio comienza a ser citado de forma directa en sus respuestas generadas.
Aunque muchos especialistas digan que un backlink no aporta al tráfico de la web, yo creo que sí que lo hace y en Google Analytics puedes verlo en Referrals. Puede que no sea mucho, como el tráfico que trae la IA, pero es un tráfico calificado que importa.
Nota mental: debemos dejar de solo buscar links y pasar a construir entidades y citabilidad
Quizá sí sea hora de replantearnos ese pensamiento obsoleto del SEO que necesita backlinks para ganar en SEO y empecemos a operar como una fuente de información de referencia para ganar posicionamiento, contabilidad y, sobre todo, autoridad temática que tanta falta le hace a Internet en este momento.
Seguimos creyendo que el mayor error del SEO Off-Page ha sido tratar a esa construcción de autoridad como un proceso transaccional aislado de la estrategia general de marketing de una compañía.
Cuando uno ve sitios webs nuevos o hace auditorías de backlinks, se da cuenta de que el webmaster o el SEO de turno (que puede que necesite resultados “rápidos” para mostrar) se mete en todo lo que encuentra y compra un lote de artículos en blogs de poca monta por su cuenta, mientras el equipo de marketing redacta notas de prensa o contenidos de blog que nadie lee y el equipo de producto recopila datos valiosos que jamás salen de las herramientas internas.
Ese enfoque de desconexión está condenado al fracaso en el ecosistema digital actual.
Necesitamos ver todas las estrategias de marketing como un ecosistema unificado de entidades, para Google y para las arquitecturas de IA, hasta para las redes sociales.
Tu marca no es un dominio web más, es una entidad semántica que posee atributos, relaciones con otras entidades, reputación, fuentes de autoría humana asociadas y una percepción de confianza global. Aprovéchala en tu beneficio para que las IA te citen y para que aumentes las ventas con el CAC más bajo de todos los canales digitales.