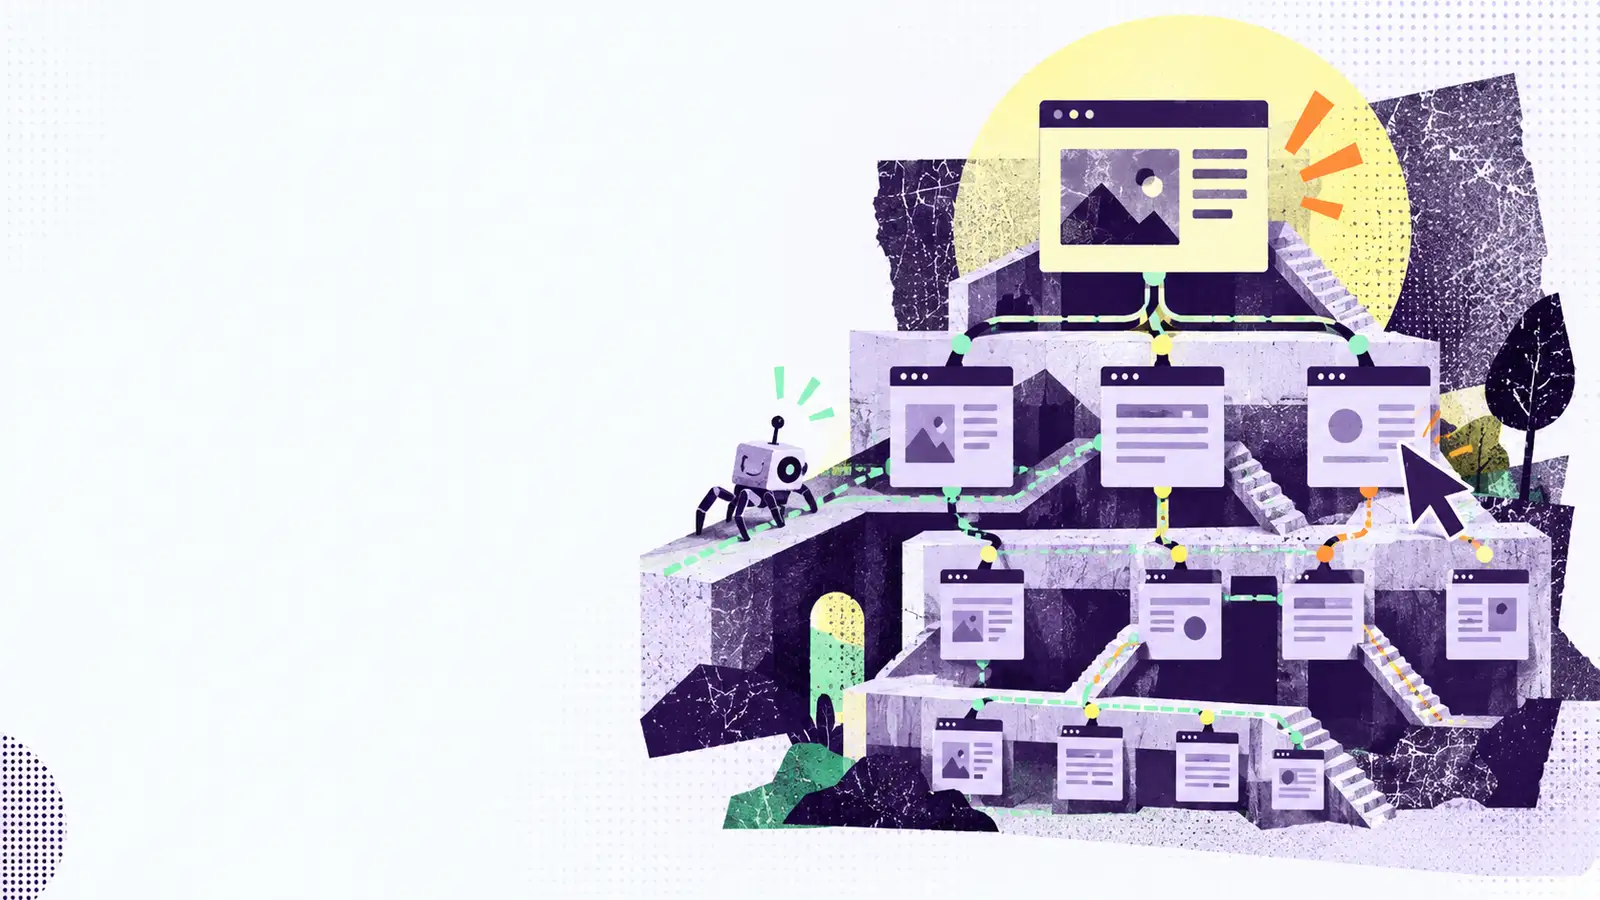
Estructurar un sitio web de forma óptima exige resolver una tensión permanente: diseñar una experiencia intuitiva, atractiva y fluida para los usuarios reales, mientras se entrega una infraestructura rígida, predecible y semánticamente cristalina para los bots de rastreo.
Si la arquitectura de tu sitio web falla en la base, cualquier esfuerzo posterior en redacción de contenidos, estrategia de palabras clave o captación de enlaces externos estará irremediablemente condicionado.
Tu arquitectura web técnica decide qué contenido se indexa en Google y en las IA
¿De qué sirve publicar el contenido más exhaustivo de tu sector si los motores de búsqueda no logran descubrirlo, interpretarlo o priorizarlo en su presupuesto de rastreo?
En el panorama digital actual, esta premisa se ha vuelto aún más crítica. Ya no diseñamos ni optimizamos únicamente para el bot tradicional de Google o Bing. La irrupción de los agentes de búsqueda generativa (GEO) y los motores de respuesta sintética (AEO) basados en modelos de lenguaje (LLMs) ha transformado la rastreabilidad en una ventaja competitiva de primer orden.
Estos nuevos rastreadores consumen recursos computacionales masivos para procesar, vectorizar e indexar información estructurada. Si tu sitio web presenta laberintos de URLs, código JavaScript opaco o estructuras taxonómicas caóticas, simplemente quedará fuera del grafo de conocimiento que alimenta las respuestas del usuario.
En nuestra experiencia auditando plataformas complejas como grandes comercios electrónicos con cientos de miles de referencias hasta medios de comunicación con publicaciones diarias de alto volumen, la arquitectura web no es un proyecto decorativo ni un ejercicio puramente estético.
La arquitectura web es la distribución de fontanería digital que determina cómo fluye la autoridad (Domain Authority y PageRank), cómo se consume la capacidad de servidor y cómo los algoritmos comprenden las relaciones jerárquicas entre tus conceptos de negocio.
Jerarquía de URLs y taxonomías: Cómo construir una estructura lógica de cero a cien
La jerarquía de URLs es la manifestación legible de tu arquitectura de información. Aunque Google ha reiterado en múltiples ocasiones que la estructura superficial de la cadena de texto de una URL no marca por sí sola la importancia de una página, la claridad taxonómica de la estructura de URLs resulta fundamental para la navegabilidad, la consolidación semántica y la analítica web.
Con el tiempo hemos aprendido que no todo lo que Google dice que NO es importante para el SEO, muchas veces sí lo es, así que en Rankeandola nos gusta experimentar de vez en cuando elementos de posible relevancia 😜, como la estructura de URLs, en este caso.
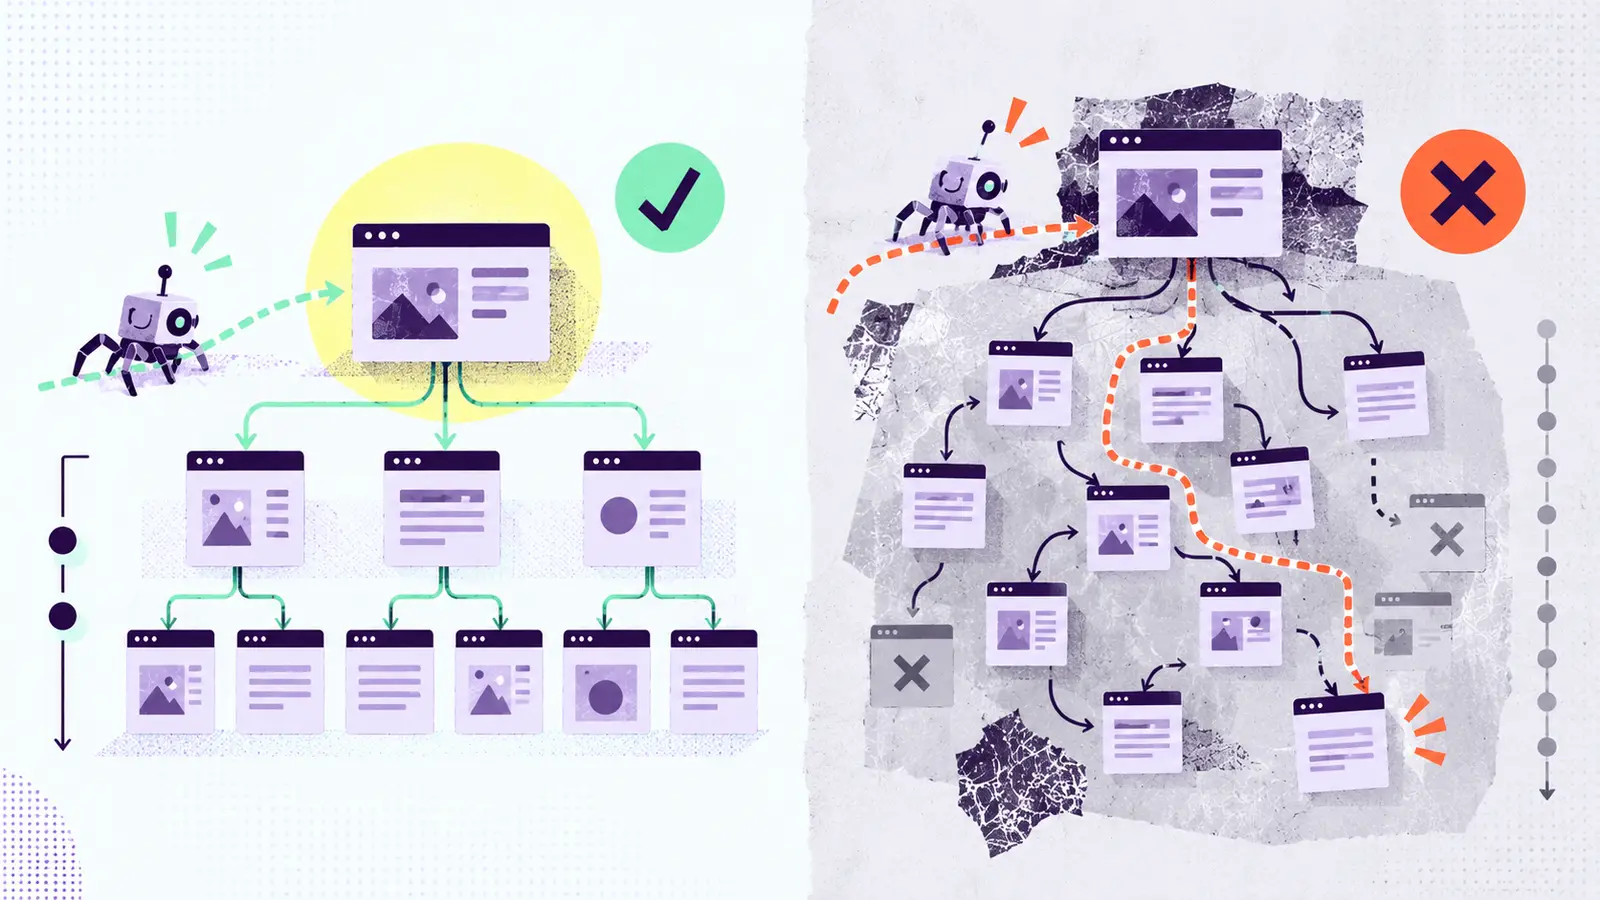
Una estructura bien concebida debe reflejar una lógica descendente, pasando de lo general a lo específico sin generar niveles de anidamiento innecesarios. El objetivo es que tanto un usuario como un algoritmo puedan inferir exactamente en qué sección del sitio se encuentran con solo mirar la barra de direcciones.
Profundidad de clics vs. Profundidad de URL
Existe una confusión habitual entre la profundidad de URL (el número de carpetas o subdirectorios reflejados en la ruta, por ejemplo: /categoria/subcategoria/producto/) y la profundidad de clics (click depth, es decir, el número real de enlaces que un usuario o bot debe seguir desde la página de inicio para llegar a un contenido).
Para los motores de búsqueda, la profundidad de clics es más determinante que la apariencia de la URL. En nuestras lecturas de comportamiento de rastreo, los bots asignan de manera sistemática mayor prioridad y frecuencia de actualización a aquellas URLs situadas a 1, 2 o 3 clics de la página principal (homepage).
Si un contenido estratégico queda enterrado a 6 o 7 clics de distancia -incluso si su URL parece limpia-, el algoritmo asumirá que el propio sitio considera ese contenido como residual o secundario.
El mito de la arquitectura plana y la realidad de los Clusters
A raíz de la importancia de la profundidad de clics, surgió el mito de que "todas las páginas deben estar a un máximo de 3 clics de la Home". Llevar esta idea al extremo suele derivar en sitios web con arquitecturas excesivamente planas donde la página de inicio enlaza un montón de URLs de forma indiscriminada.
Esto diluye trágicamente la transferencia de autoridad y se pierde la categorización contextual de las temáticas, sin contar lo difícil que puede llegar a ser definir el orden de relevancia.
La solución óptima radica en la implementación de Topic Clusters o clústeres temáticos mediante Siloing. Esta técnica organiza la información en bloques semánticos aislados o interconectados de forma estrictamente vertical y transversal:
Página Pilar (Pillar Page / Categórica): Ataca la intención de búsqueda más amplia e intencional. Recibe el flujo principal de autoridad desde la página de inicio o la navegación principal.
Subcategorías / Subtemas: Profundizan en vertientes específicas de la temática principal.
Páginas de Contenido Específico (Cluster Content / Fichas de producto / Artículos): Responden a intenciones long-tail o transaccionales concretas y enlazan de vuelta hacia la página pilar usando anclas contextuales relevantes.
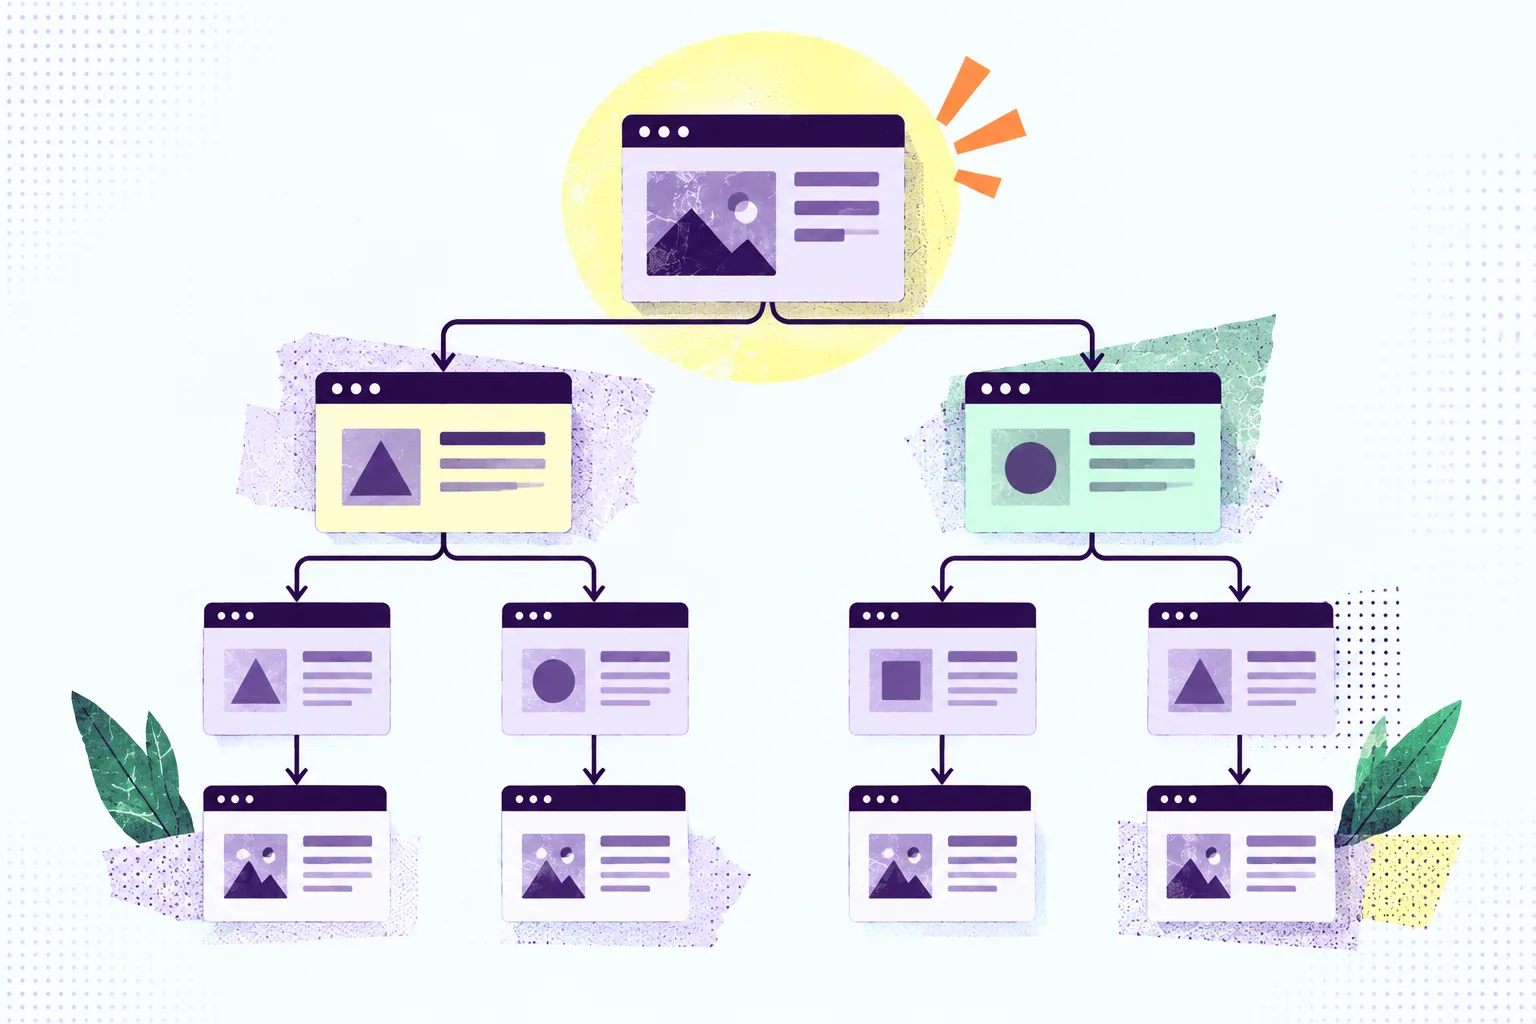
En cuanto al tradicional debate para muchos SEOs vieja guardia como nosotros entre subdirectorios vs. subdominios (ejemplo.com/blog/ frente a blog.ejemplo.com), la evidencia del sector SEO muestra que los subdirectorios heredan la autoridad y la confianza del dominio raíz de forma inmediata y consolidada. En cambio, los subdominios suelen ser tratados por los algoritmos como entidades independientes que requieren su propio esfuerzo de rastreabilidad y acumulación de autoridad.
Crawl Budget y Rastreabilidad: Optimizando el paso de los bots por tu servidor
El Crawl Budget (presupuesto de rastreo) no es un número místico fijado arbitrariamente; es la combinación de dos factores técnicos claramente delimitados por Google: la capacidad de rastreo (Crawl Rate Limit, determinada por los límites de respuesta del servidor para no ahogarlo) y la demanda de rastreo (Crawl Demand, determinada por la popularidad, frescura e importancia relativa del contenido).
Para sitios web de pequeño o mediano tamaño (con menos de 10.000 URLs), el presupuesto de rastreo rara vez supone un cuello de botella crítico. Sin embargo, en plataformas e-commerce, sitios de clasificados o medios de comunicación masivos, la gestión ineficiente del Crawl Budget puede provocar que contenidos estratégicos tarden semanas en indexarse o actualizarse en los resultados de búsqueda.
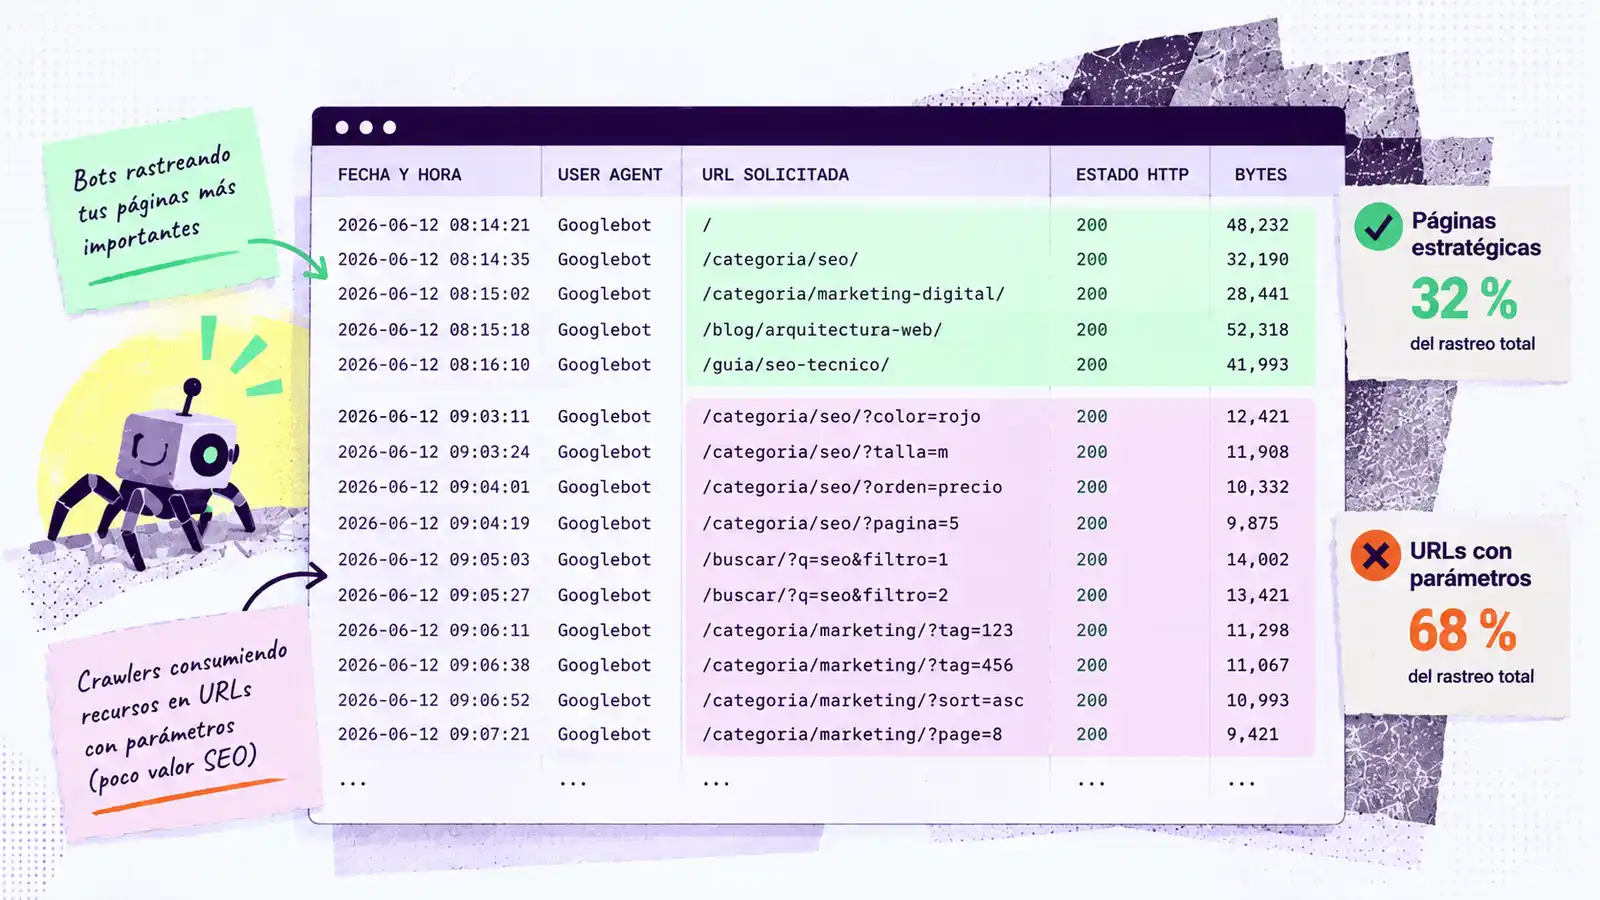
Navegación faceteada y parámetros que generan contenido duplicado
La navegación faceteada, popular en tiendas en línea donde el usuario filtra por talla, color, marca, precio o disponibilidad, es el enemigo público número uno de la rastreabilidad si no está correctamente aislada.
Una combinación descontrolada de 5 filtros en una categoría con 1.000 productos puede generar matemáticamente millones de URLs dinámicas únicas que ofrecen variaciones mínimas o nulas de contenido real.
Si los bots entran libremente en esos bucles de parámetros (?color=rojo&talla=xl&sort=price_asc), consumirán la capacidad de tu servidor descargando miles de páginas idénticas. Para mitigar esta sangría de recursos, existen diferentes enfoques técnicos que deben aplicarse con precisión quirúrgica:
Inhabilitación vía robots.txt: Bloquea carpetas o rutas de parámetros explícitos mediante directivas Disallow. Es la forma más tajante de impedir que el bot pierda tiempo descargando la URL, aunque no evita que la URL pueda ser descubierta si recibe enlaces externos.
Uso de la etiqueta canonical: Le indica al motor de búsqueda cuál es la versión canónica o preferida que debe indexar. Atención: la directiva canonical es una sugerencia, no una orden. Si el bot detecta que la página duplicada difiere considerablemente de la canónica, ignorará la sugerencia y continuará gastando recursos de rastreo.
Cierre táctico con noindex: Permite que el bot rastree la página pero le prohíbe guardarla en el índice. Ojo: para que un noindex sea procesado, el bot debe poder rastrear la página. Si la bloqueas simultáneamente en el robots.txt, el bot nunca leerá la etiqueta noindex.
Manejo de estados con JavaScript / AJAX (sin alterar la URL con parámetros rastreables): Cargar los filtros faceteados mediante llamadas asíncronas que no generen URLs navegables por enlaces <a href> estándar para los bots.
Páginas huérfanas y bucles de redirección
Las páginas huérfanas son aquellas URLs que existen en tu servidor y están indexadas (o disponibles para indexar), pero que carecen de enlaces internos que apunten hacia ellas dentro de la estructura de navegación del sitio.
Los bots solo pueden descubrirlas a través del archivo Sitemap.xml o mediante enlaces externos. Estas páginas fragmentan la coherencia semántica de tu arquitectura y representan un callejón sin salida para el usuario.
Por otro lado, los cadenas y bucles de redirección (HTTP 301 o 302) actúan como ralentizadores directos del proceso de rastreo. Cada salto en una cadena de redirecciones implica una nueva llamada de red HTTP para el bot.
Si un bot topa con una cadena de 4 o 5 saltos, la mayoría de los rastreadores abandonarán el hilo de rastreo antes de llegar al destino final, malgastando tu Crawl Budget e impidiendo la correcta consolidación de la autoridad de enlace.
Renderizado moderno: SSR, CSR, SSG
La evolución de los frameworks de JavaScript en el desarrollo web moderno (React, Vue, Angular, Next.js, Nuxt) ha redefinido drásticamente la manera en que los navegadores y los bots interpretan el código de un sitio. Comprender los modelos de renderizado es indispensable para evitar sorpresas en la indexación.
Modelo de Renderizado | ¿Dónde se ejecuta el código? | Impacto en Rastreabilidad / SEO | Rendimiento inicial (FCP / LCP)
|
|---|---|---|---|
Server-Side Rendering (SSR) | En el servidor web por cada petición | Excelente: El bot recibe el HTML con contenido completo en la primera respuesta. | Medio a Rápido (depende del servidor y TTFB). |
Client-Side Rendering (CSR) | En el navegador/bot mediante JavaScript | Riesgo Alto: Requiere que el bot ejecute el JS (segunda ola de indexación). | Rápido tras la carga inicial, pero FCP lento. |
Static Site Generation (SSG) | En tiempo de compilación (build time) | Excelente: Archivos HTML estáticos listos para consumo directo. | Ultra Rápido (ideal para CDN). |
Incremental Static Regeneration (ISR) | Compilación estática bajo demanda | Excelente: Mezcla la velocidad del SSG con actualización dinámica. | Muy Rápido. |
El coste oculto del Client-Side Rendering (CSR) en la indexación
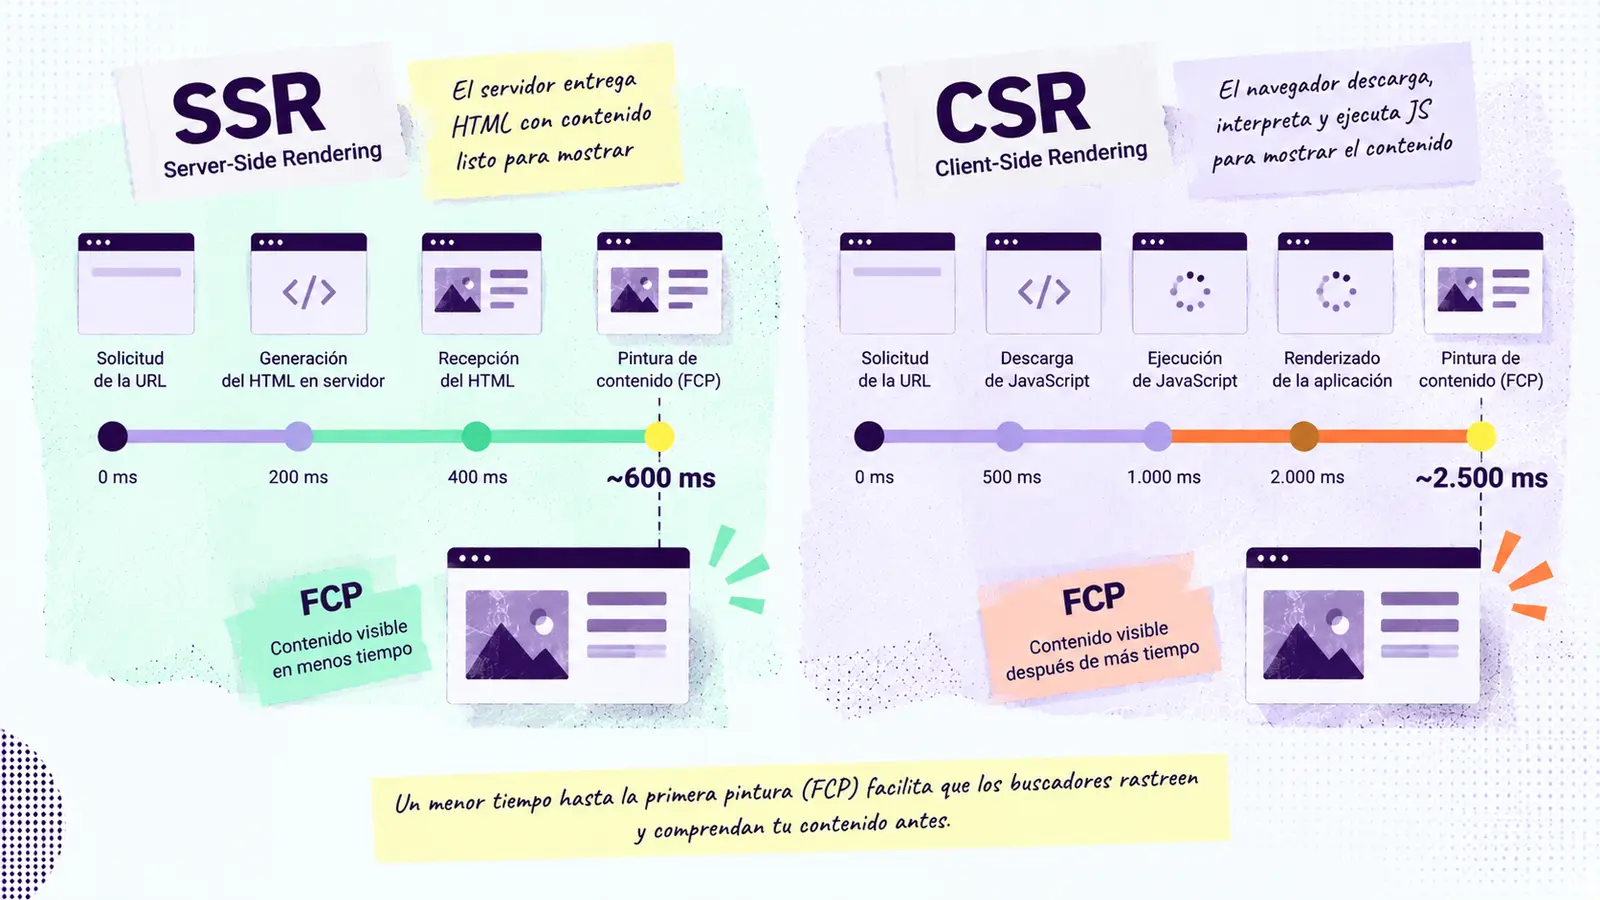
Cuando implementas una arquitectura puramente basada en Client-Side Rendering (CSR), el servidor entrega un archivo HTML prácticamente vacío con un fragmento de código similar a este: <div id="app"></div> junto con varios archivos .js de gran tamaño.
Para un usuario humano con un navegador moderno, el archivo JavaScript se descarga, se ejecuta y dibuja la interfaz. Sin embargo, para los rastreadores de búsqueda y los agentes de IA, el proceso es muy distinto:
Fase de Rastreo (Crawl): El bot descarga la respuesta inicial del servidor (el HTML básico de unos cuantos bytes).
Cola de Renderizado (Render Queue): Si el bot detecta que requiere JavaScript para ver el contenido, envía la página a una cola de renderizado diferido. Este proceso requiere el Web Rendering Service (WRS), un entorno computacionalmente costoso.
Ejecución y Segunda Ola de Indexación: Días o incluso semanas después (dependiendo de los recursos de renderizado disponibles), el bot ejecuta el código JS, descubre los enlaces dinámicos e indexa el texto renderizado en el DOM (Document Object Model).
Si tus enlaces contextuales internos están generados únicamente tras la ejecución de eventos de JavaScript o mediante elementos sin etiquetas estándar HTML (por ejemplo, en eventos <div onclick="..."> en lugar de <a href="...">), los bots de búsqueda e IA simplemente no seguirán esos enlaces.
(Avanzado) Hidratación, Core Web Vitals y el impacto en la experiencia del usuario
Incluso en arquitecturas híbridas donde se utiliza SSR con Hidratación (el servidor entrega el HTML estático renderizado y posteriormente JavaScript "hidrata" el sitio adjuntando los eventos interactivos en el navegador del cliente), surgen retos de SEO técnico.
Una hidratación deficiente o pesada produce bloqueos en el hilo principal del navegador (Main Thread), impactando directamente en métricas críticas de Core Web Vitals como la Interaction to Next Paint (INP) o la Cumulative Layout Shift (CLS) cuando el DOM muta de repente tras ejecutar el código de cliente.
Para mitigar un problema de bloqueo de lectura por hidratación, en nuestra práctica recomendamos adoptar patrones de hidratación parcial o progresiva (Island Architecture), garantizando que la estructura semántica esencial sea completamente estática e inmune a las fallas de ejecución del lado del cliente.
Este es uno de los puntos más avanzados y técnicos con los que podrías encontrarte, y aunque no es muy común, la forma de creación de sitios nuevos con Software de IA, Claude code o similares, a veces crea sitios que impiden el correcto rastreo de motores de búsqueda debido a la tecnología que la IA considera adecuada para tu sitio.
Estructura semántica y enlazado interno
Una vez resuelta la rastreabilidad física de tu contenido (que el bot pueda llegar a la página y descargar su contenido), la siguiente capa de la arquitectura es la comprensión semántica.
¿Cómo entiende el algoritmo qué relación guarda una página con otra dentro del ecosistema de tu marca?
Distribución de PageRank interno y textos de anclaje contextuales
El algoritmo de PageRank original sigue estando en el corazón de la evaluación de importancia de páginas por parte de los motores de búsqueda. El enlazado interno es el mecanismo mediante el cual distribuyes el flujo de PageRank (equity) a través de las diferentes páginas de tu dominio.
Para maximizar la eficacia del enlazado interno:
Textos de anclaje (Anchor Text) descriptivos: Evita enlaces genéricos del tipo "haz clic aquí", "saber más" o "fuente". El texto de anclaje debe incluir variaciones semánticas y términos clave que definan con precisión el tema de la página de destino.
Contextualización en el cuerpo del contenido (In-Content Links): Los enlaces situados dentro del bloque principal de texto (<main> o <article>) transmiten significativamente más relevancia y contextodad que aquellos ubicados en elementos globales como el pie de página (footer) o la barra lateral (sidebar).
Evita el aislamiento mediante silos estrictos pero inconexos: Aunque la arquitectura en silo es potente para definir temáticas, los silos no deben ser prisiones infranqueables. Si dos conceptos de silos distintos guardan una relación conceptual lógica para el usuario, enlázalos transversalmente. Esto ayuda a la IA a construir un grafo de entidades coherente sobre tu negocio.
Marcado de datos estructurados: La traducción directa para motores de IA
El marcado de datos estructurados en formato JSON-LD (bajo los estándares de Schema.org) es el intérprete universal que conecta la arquitectura visual de tu sitio con los modelos de procesamiento de lenguaje natural (NLP) y los motores de IA.
Mientras que un texto plano requiere parsing e inferencia probabilística por parte del bot, un fragmento JSON-LD bien construido declara hechos estructurados incontestables. Para una arquitectura web robusta, los esquemas imprescindibles incluyen:
Organization / LocalBusiness: Establece la entidad principal y las relaciones de autoría de tu marca.
WebSite con SearchAction: Define la funcionalidad de búsqueda interna.
BreadcrumbList: Refuerza explícitamente la jerarquía taxonómica de la URL para que el motor dibuje migas de pan impecables en las SERPs.
ItemPage, Product, Article, FAQPage: Definen la tipología exacta de la plantilla y su propósito contextual.
Qué NO deberías hacer jamás en la arquitectura de tu sitio web
A lo largo de las auditorías técnicas que hacemos en Rankeandola, hemos identificado un patrón recurrente de prácticas que afectan instantáneamente la salud arquitectónica de un sitio web. Evita los siguientes errores:
Crear enlaces sin el atributo href válido: Implementar navegación basada únicamente en eventos de JavaScript (<button onclick="location.href='...'"> o <a void(0)>) impide que el rastreador descubra la ruta. Si no hay un elemento <a href="/ruta-destino">, el bot clásico no sigue el enlace.
Abusar de las etiquetas de canonicidad para solucionar problemas de arquitectura: La directiva canonical no debe usarse como una tirita para ocultar contenidos duplicados masivos generados por mala estructuración. Si 20 URLs ofrecen esencialmente lo mismo, la solución técnica no es canonicalizarlas a todas hacia una principal y dejar las 20 en la navegación; la solución correcta es consolidar el contenido, aplicar redirecciones 301 o reestructurar el sistema de URLs.
Inclusión de URLs no canónicas o bloqueadas en el XML Sitemap: El Sitemap XML debe ser una lista limpia de "URLs perfectas": respuestas HTTP 200 OK, canónicas hacia sí mismas, sin etiqueta noindex y totalmente rastreables. Incluir URLs con redirecciones, errores 404 o bloqueadas por robots.txt confunde a los bots sobre tus verdaderas prioridades de indexación.
Depender exclusivamente de migas de pan (breadcrumbs) visuales basadas en el historial del navegador: Las migas de pan deben reflejar la jerarquía estática de la arquitectura de información (Home > Categórica > Subcategórica > Producto), no la ruta navegacional aleatoria que ha seguido un usuario concreto en su sesión mediante window.history.
Ignorar las páginas huérfanas en las migraciones: Cambiar la estructura de URLs sin mapear de forma exhaustiva la totalidad de las URLs antiguas mediante redirecciones 301 uno a uno rompe la continuidad de rastreo y provoca la pérdida irreversible del valor acumulado de PageRank.
Framework paso a paso: Cómo auditar y reestructurar tu arquitectura sin perder tráfico
Si te enfrentas al reto de auditar o rediseñar la arquitectura de un sitio web en producción, abordar el cambio sin una metodología rigurosa puede poner en riesgo el tráfico orgánico existente. Si no es tu caso te recomendamos seguir la lectura en el siguiente punto.
A continuación te presentamos el framework de trabajo que utilizamos para ejecutar reestructuraciones técnicas de forma segura:
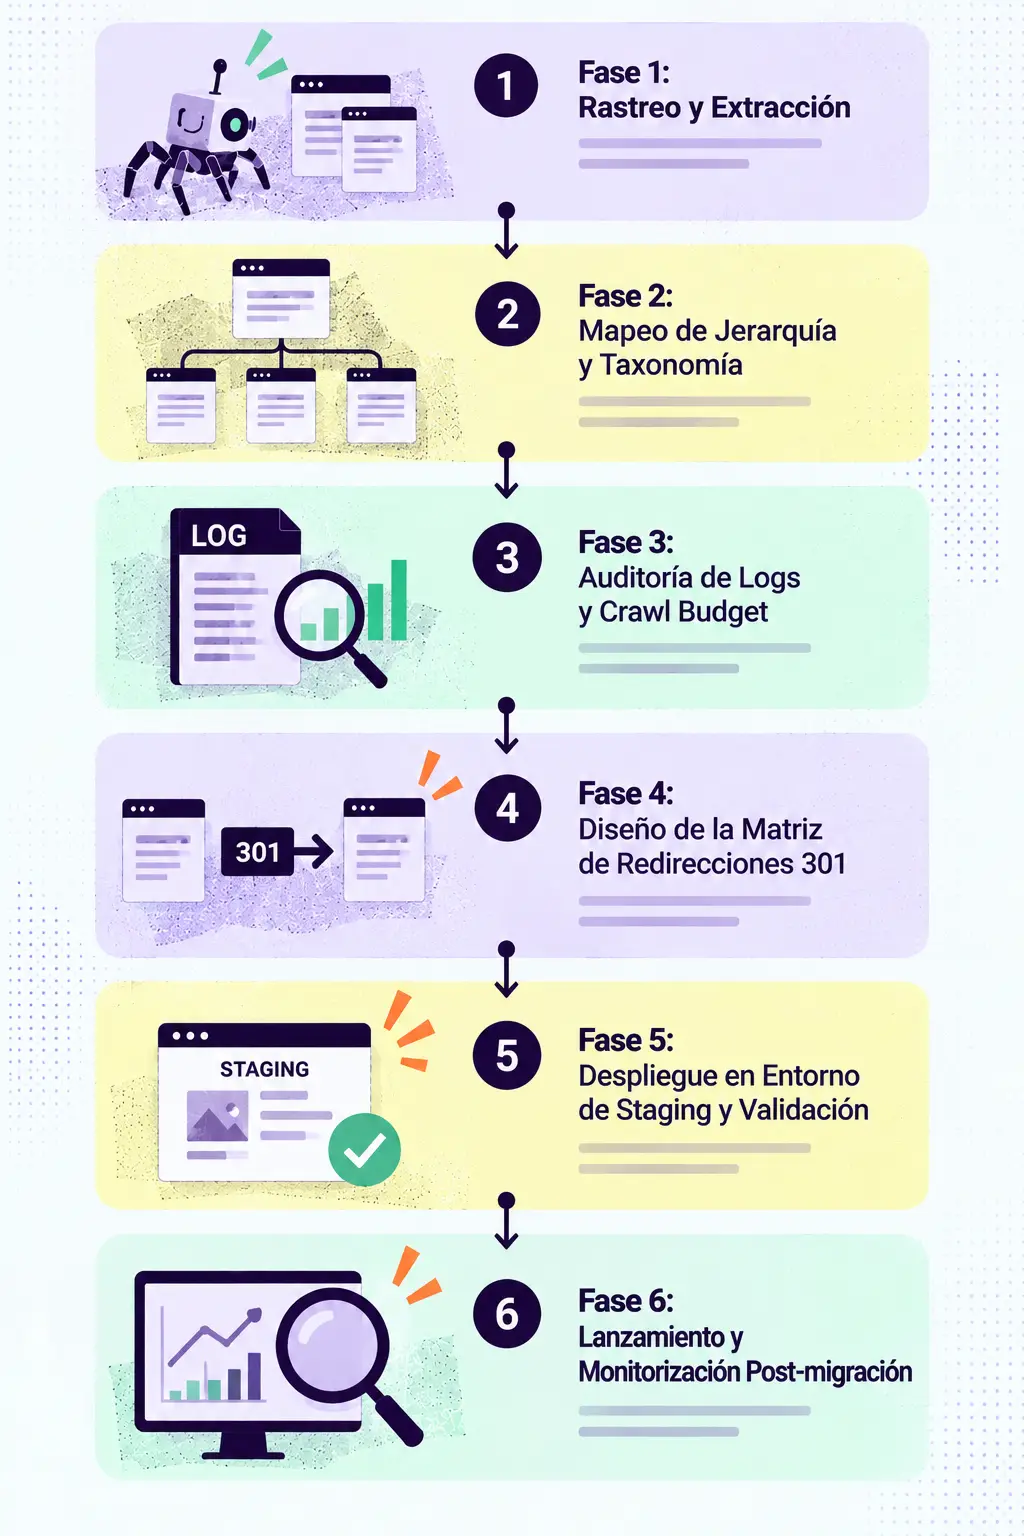
Paso 1: Rastreo completo y extracción de la arquitectura actual
Utiliza herramientas de rastreo (crawlers de escritorio o en la nube) configuradas para emular tanto el bot tradicional de escritorio como el móvil de Googlebot.
Extrae el árbol completo de URLs, la profundidad de clics de cada página, las etiquetas canonical, el estado de respuesta HTTP y la presencia de etiquetas de marcado Schema.org.
Cruza estos datos con las métricas de tráfico analítico de los últimos 12 meses y datos de Search Console para clasificar las páginas en tres grupos: Páginas de Alto Rendimiento, Páginas Neutras/Oportunidad y Páginas Basura/Sin Tráfico.
Paso 2: Análisis de archivos de Log del servidor (Log Analysis)
Consigue el acceso a los registros de peticiones (access logs) de tu servidor web (Nginx, Apache, Cloudflare).
Analiza la presencia de los bots de búsqueda (Googlebot, Bingbot, GPTBot, etc.).
Identifica qué porcentaje de las peticiones de los bots se gasta en páginas con estado 200 frente a respuestas 301, 404, 500 o parámetros dinámicos de navegación faceteada.
Detecta zonas del sitio web que sufren de inanición de rastreo (crawl starvation), es decir, secciones estratégicas que el bot apenas visita debido a una excesiva profundidad de clics.
Paso 3: Diseño de la nueva arquitectura de información
Diseña el nuevo mapa de sitio estático proyectando la taxonomía óptima:
Define las categorías principales, subcategorías y los clústeres temáticos.
Asegúrate de que el 100% de los contenidos estratégicos se encuentren a una profundidad de clics ≤ 3.
Elimina redundancias, fusiona contenidos delgados (thin content) mediante consolidación semántica y establece directivas claras para el manejo de parámetros.
Paso 4: Creación de la matriz de redirecciones y entorno de pruebas (Staging)
Si la nueva arquitectura exige cambios en la estructura de URLs, crea una matriz de mapeo 1:1 conectando la URL antigua con su equivalente exacta en la nueva estructura. Evita enviar todas las redirecciones masivamente hacia la página de inicio.
Despliega la nueva arquitectura en un entorno de desarrollo o staging protegido por autenticación HTTP básica (para impedir que los bots indexen el entorno de pruebas antes de tiempo).
Audita el entorno de staging comprobando el correcto funcionamiento del renderizado (SSR/SSG), la integridad de los datos estructurados JSON-LD y la usabilidad en dispositivos móviles.
Paso 5: Lanzamiento y monitorización intensiva post-migración
Ejecute los cambios en producción y actualice inmediatamente los archivos XML Sitemap en Google Search Console y Bing Webmaster Tools.
Realiza inspecciones de URLs en tiempo real para verificar que las directivas de indexación se están procesando correctamente.
Monitoriza a diario los datos de rastreo en los logs de servidor para comprobar con qué rapidez los bots están descubriendo la nueva jerarquía y procesando las redirecciones 301.
De pensar en "rastreadores de búsqueda" a "agentes de consumo sintético"
El SEO técnico tradicional se concibió bajo una premisa relativamente sencilla: un robot descargaba un archivo de texto HTML, parseaba los enlaces internos, asignaba un peso de PageRank al sitio e indexaba las palabras clave encontradas en el documento.
Hoy nos encontramos en plena transición hacia una era dominada por la Optimización para Motores Generativos (GEO) y los Motores de Respuesta (AEO). Los modelos de lenguaje y los agentes de IA autónomos (como Chatgpt, Perplexity o Claude) consumen la web de una forma radicalmente distinta:
Lectura sintáctica directa: Los LLMs prefieren datos estructurados, limpios y declarativos por encima del diseño visual. Para un agente de IA, una arquitectura web caótica cargada de dependencias en scripts de cliente dificulta la extracción limpia de entidades y relaciones de negocio.
Evaluación de la coherencia jerárquica: Cuando un agente de IA evalúa la autoridad temática (topical authority) de tu sitio para citarlo como respuesta factual, analiza la solidez de tu arquitectura. Un dominio con clústeres semánticos bien acotados e interconectados transmite una señal de especialización incomparablemente superior a la de un sitio heterogéneo con URLs desordenadas.
Eficiencia en la ingesta de datos: Procesar información en la era de la IA requiere un gasto computacional gigantesco. Las plataformas de respuesta sintética priorizarán la extracción periódica de información en sitios cuya arquitectura garantice un acceso rápido, ligero, semánticamente enriquecido y técnicamente predecible.
Cambiar el chip mental implica dejar de ver la arquitectura web como un mero checklist para complacer a un bot de búsqueda clásico. La arquitectura web debe ser entendida como la API semántica pública de tu sitio web para el ecosistema de inteligencia artificial.
Para cerrar: la arquitectura como ventaja competitiva sostenible en la era de la IA
En un entorno digital extremadamente competitivo donde los contenidos generados por IA crecen a gran velocidad, el contenido por sí solo ha dejado de ser un factor diferencial.
La verdadera ventaja competitiva radica en cómo entregas ese contenido, la calidad, la velocidad con la que los algoritmos pueden descubrirlo y la solidez semántica de la estructura que lo soporta.
Una arquitectura web limpia, diseñada con una jerarquía de URLs intuitiva, una gestión eficiente del Crawl Budget, un modelo de renderizado enfocado en el rendimiento y un marcado de datos estructurados impecable, genera un efecto dominó positivo en todo tu ecosistema digital:
Para los usuarios: Ofrece una navegación ágil, lógica y placentera que mejora las conversiones y reduce la tasa de rebote.
Para los motores de búsqueda tradicionales: Garantiza una indexación rápida, fluida y una distribución óptima de la autoridad de tu sitio.
Para los agentes de IA y motores generativos: Proporciona un grafo de conocimiento estructurado, confiable y fácilmente procesable que posiciona a tu marca como la fuente de referencia en su sector.
Invertir tiempo y recursos en tener una arquitectura web saludable no es un lujo técnico opcional hoy en día! es la base indispensable para asegurar visibilidad, relevancia y la supervivencia de tu negocio en la web del presente y del futuro.